Architectuur met lage latentie voor Solana HFT
Er komt data binnen, maar de prijzen waarop je applicatie haar beslissingen baseert, zijn nog steeds verouderd. Bij een Solana HFT-applicatie moet je zowel de rekentijd onderzoeken als de tijd die ontvangen data wacht voordat ze in een beslissing wordt gebruikt. Eerdere updates kunnen nog op verwerking wachten, een logrecord is misschien nog niet opgeslagen, of een update voor een andere markt houdt een lock vast. De manier waarop je de code organiseert, beïnvloedt die wachttijden.
Dit artikel laat met vijf patronen zien waar binnenkomende data wacht en welk werk verder kan wanneer het ontwerp verandert. Je kunt ook beginnen bij het symptoom dat bij jouw applicatie past en direct naar die paragraaf gaan.
| Wat gebeurt er in de applicatie? | Welk ontwerp onderzoek je? |
|---|---|
| Hoe langer de applicatie draait, hoe meer onverwerkte data zich ophoopt | 1. Aankomstsnelheid, verwerkingssnelheid en grenzen aan wachten |
| De volgende prijs kan niet worden verwerkt terwijl een record wordt opgeslagen | 2. Werk dat nodig is voor beslissingen scheiden van analytische logging |
| Een update van markt A laat ook een update van markt B wachten | 3. Locks opsplitsen die onafhankelijke toestanden beschermen |
| Bij elke ontvangst wordt dezelfde voorbereiding herhaald | 4. Onveranderlijke onderdelen vooraf voorbereiden en hergebruiken |
| Beslissingen gebruiken oude waarden, ook nadat de verbinding is hersteld | 5. Verbindingsherstel onderscheiden van herstel van de toestand voor beslissingen |
Elke sectie eindigt met kopieerbare instructies om die verbetering op je applicatie toe te passen. Geef ze aan een AI-agent die de code van je project kan lezen.
De aantallen, prijzen, aantallen bewerkingen en tijdsduren in de diagrammen zijn illustratieve modellen. Ze geven geen gemeten prestaties of handelsresultaten weer.
Tik of klik op een diagram om de afbeelding op volledige grootte te openen.
1. Vergelijk de instroom met de verwerkingscapaciteit en begrens het wachten
Stel dat een applicatie in elk even lang tijdsinterval zes gebeurtenissen ontvangt en er twee kan verwerken. Aan het einde van het eerste interval blijven vier gebeurtenissen onverwerkt. Een wachtrij is de plek waar data op verwerking wacht.
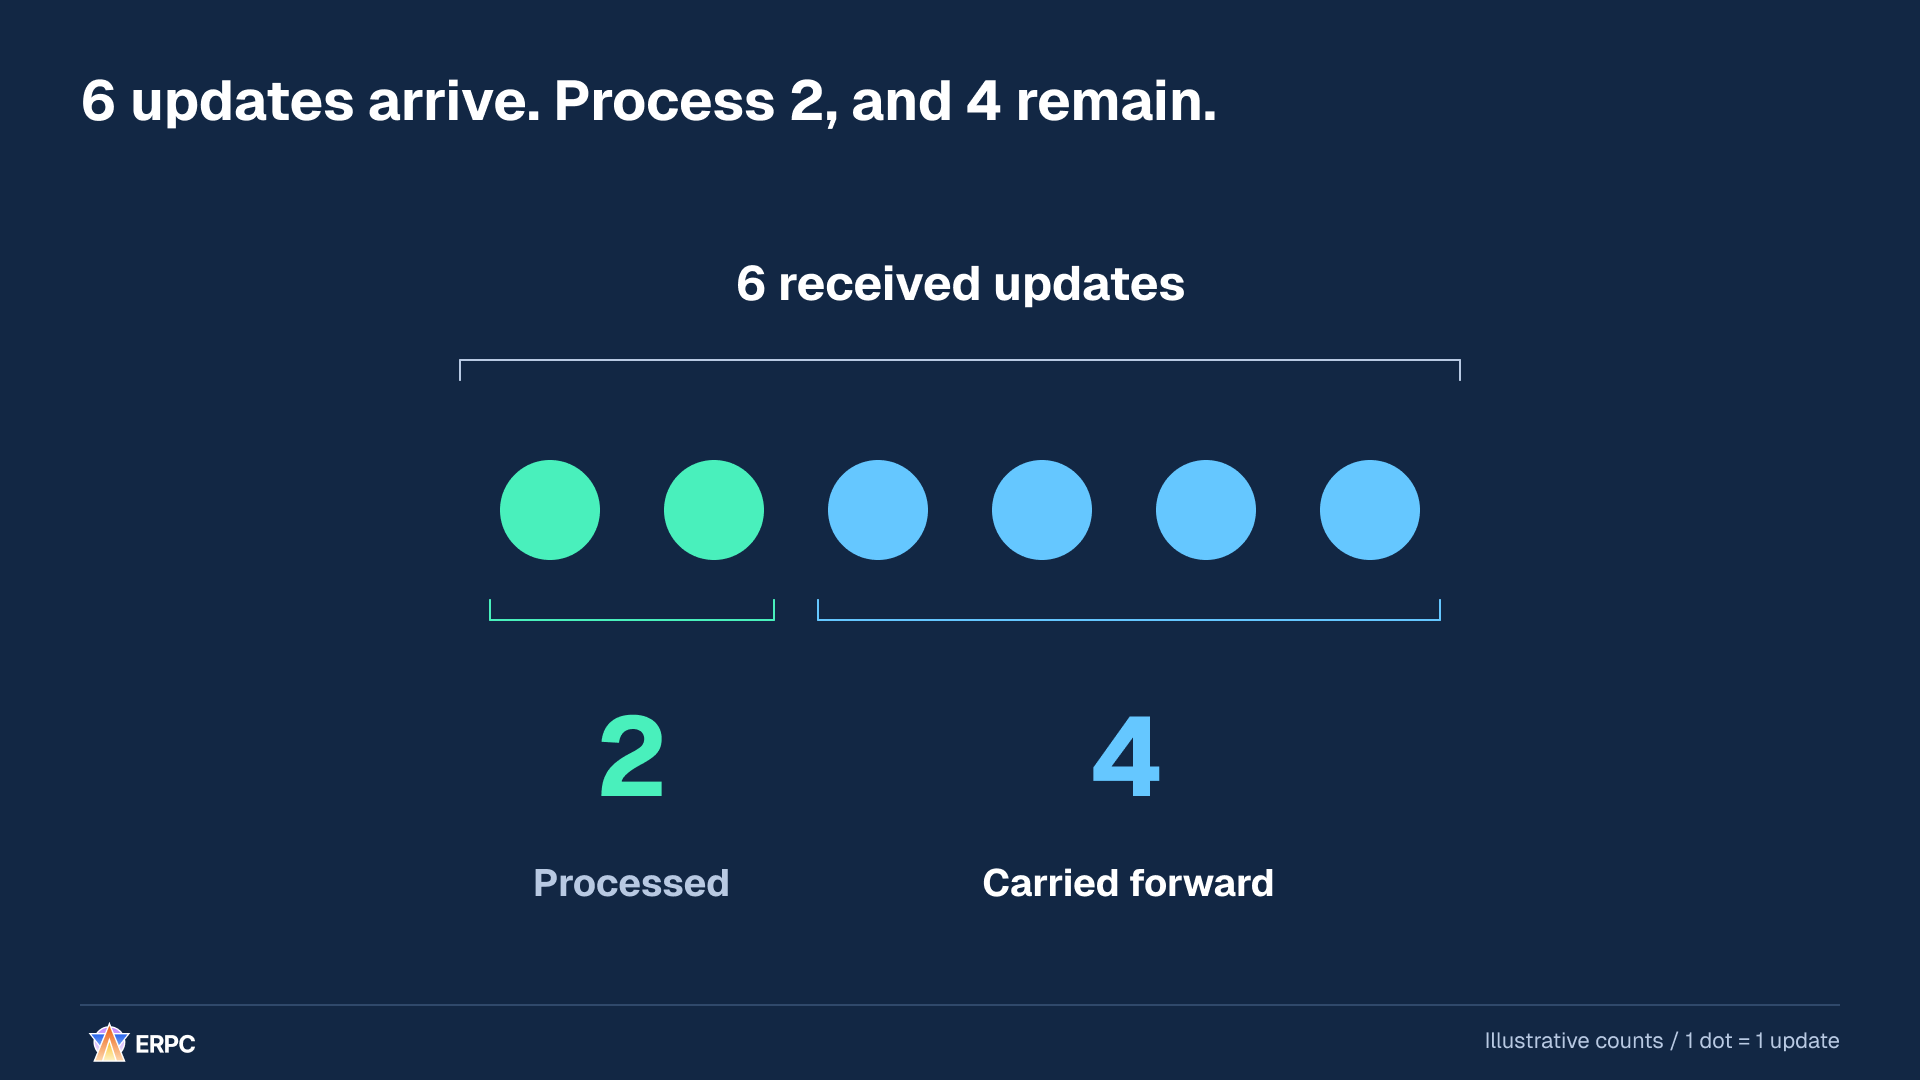
De verwerking gaat door, maar vier gebeurtenissen zijn nog niet voor beslissingen gebruikt.
Vergroot nu dezelfde verhouding naar 60.000 binnenkomende gebeurtenissen. Als er 20.000 worden verwerkt, blijven er 40.000 wachten. Rechts in het diagram staat elke stip voor 100 gebeurtenissen en elke groep van 100 stippen voor 10.000 gebeurtenissen. Twee groepen zijn verwerkt en vier groepen wachten nog.
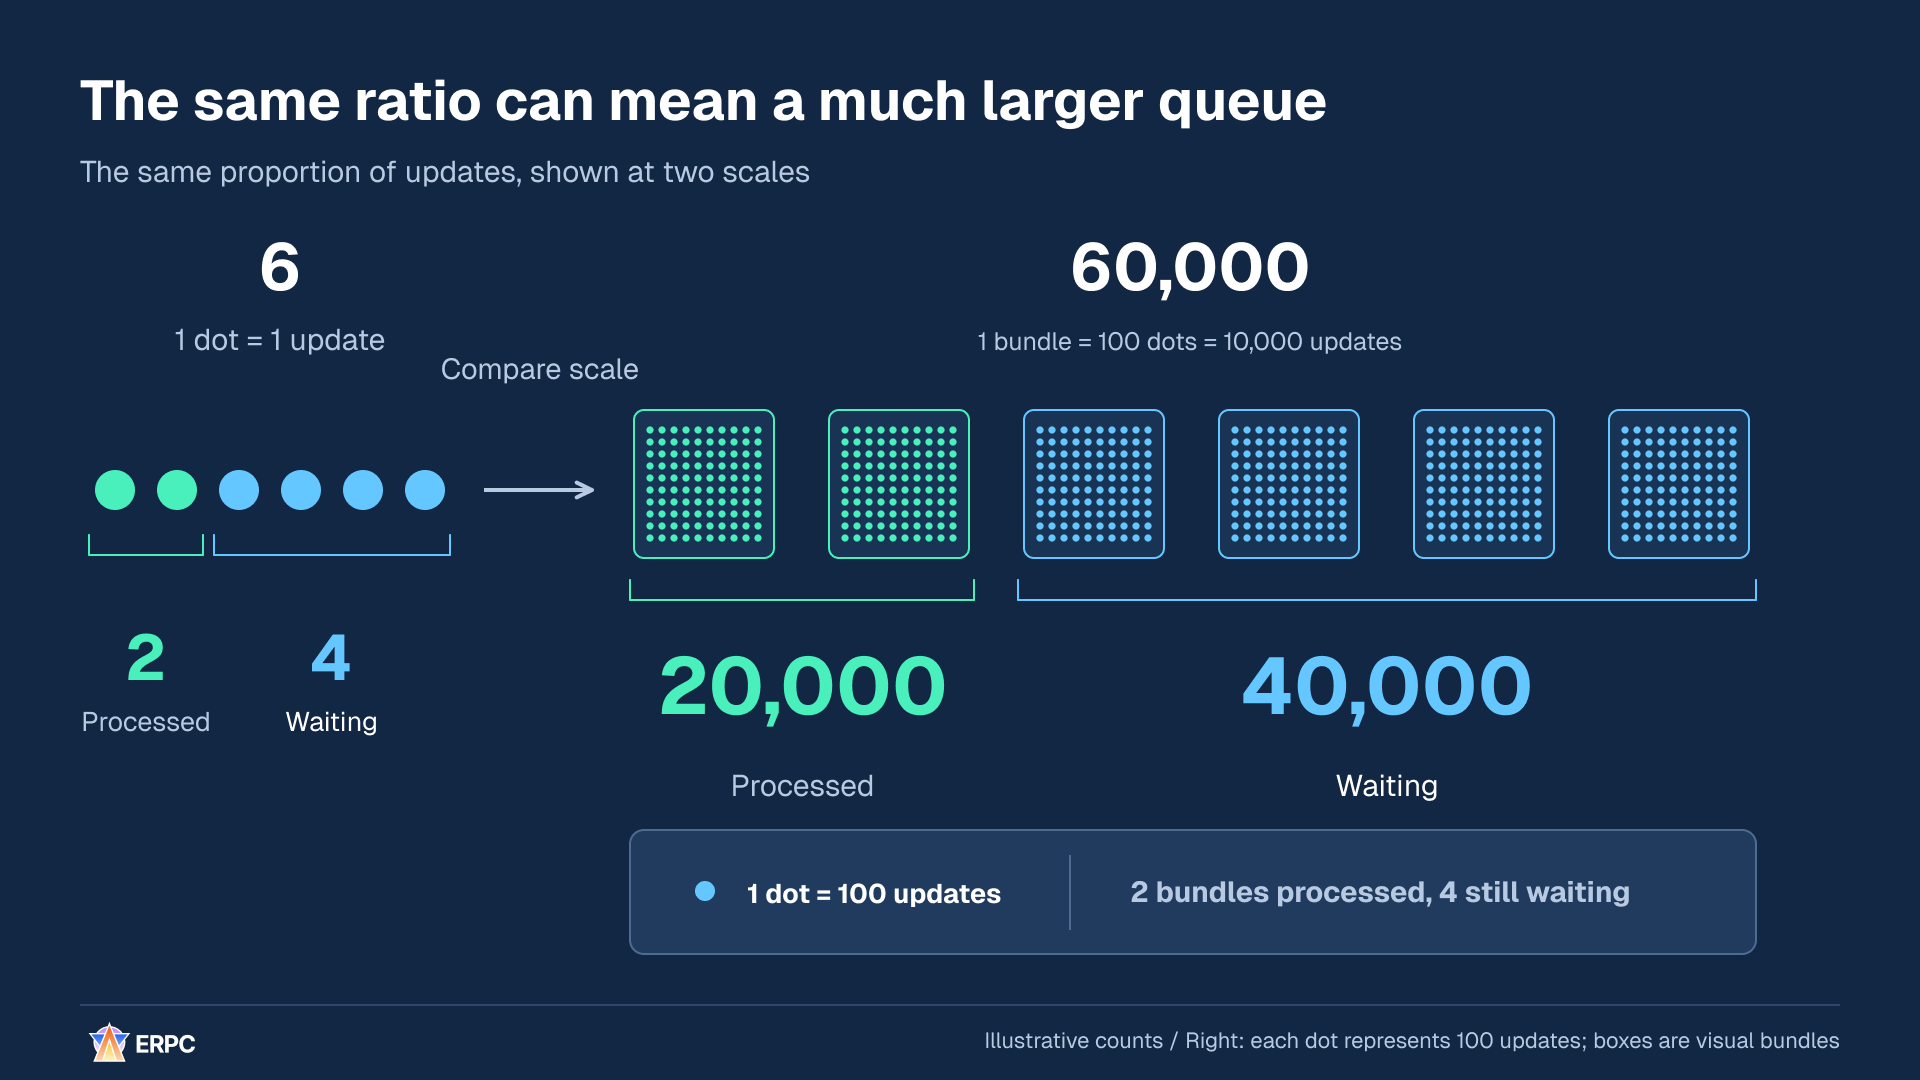
De groepen rechts zijn een manier om de hoeveelheid zichtbaar te maken. Ze stellen geen verwerkingsbatches in de applicatie voor.
Het volgende interval begint met 40.000 wachtende gebeurtenissen. Er komen nog eens 60.000 bij en er worden 20.000 verwerkt, zodat er 80.000 overblijven. Het daaropvolgende interval eindigt met 120.000. Nieuw binnenkomende prijzen moeten achter het werk wachten dat al in de wachtrij staat.
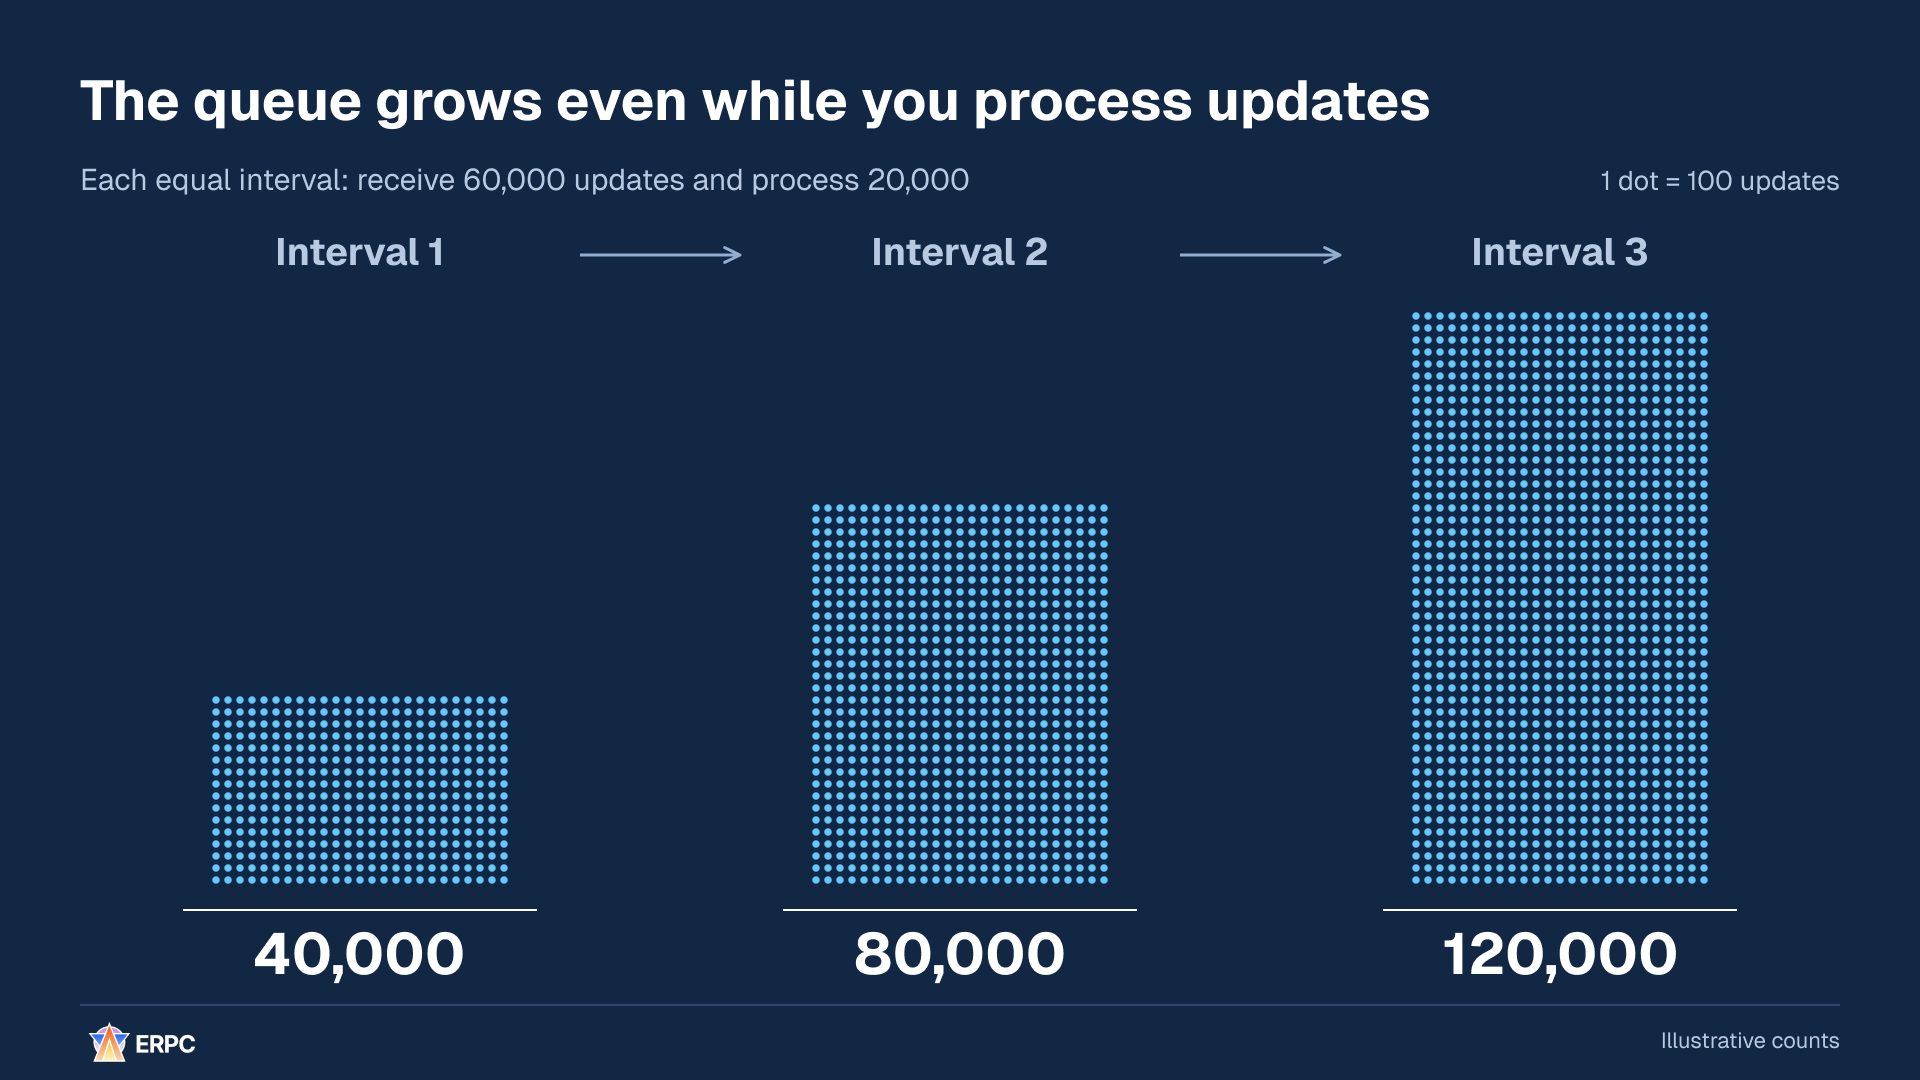
Wanneer de instroom de verwerkingscapaciteit blijft overschrijden, blijft de achterstand groeien.
Een wachtrij helpt pieken op te vangen: korte perioden waarin veel data tegelijk binnenkomt. Meer capaciteit lost een aanhoudend verwerkingstekort zoals in dit voorbeeld niet op. Meet naast het aantal bewaarde items en bytes ook hoe lang het oudste item al wacht en stel een aanvaardbare grens vast. Als niet meer aan de vereiste actualiteit wordt voldaan, pauzeer dan nieuwe handelsbeslissingen die van die waarden afhangen, ook als er geen updates verloren zijn gegaan.
Wat moet er gebeuren als die grens wordt bereikt? In het volgende diagram zijn alle acht beschikbare plaatsen bezet wanneer twee nieuwe updates binnenkomen. Als die twee updates niet kunnen worden bewaard en nodig zijn voor een beslissing, kan de applicatie haar opgeslagen waarden niet meer correct bijwerken. Pauzeer nieuwe handelsbeslissingen die van die waarden afhangen en hervat ze nadat de noodzakelijke updates zijn hersteld.
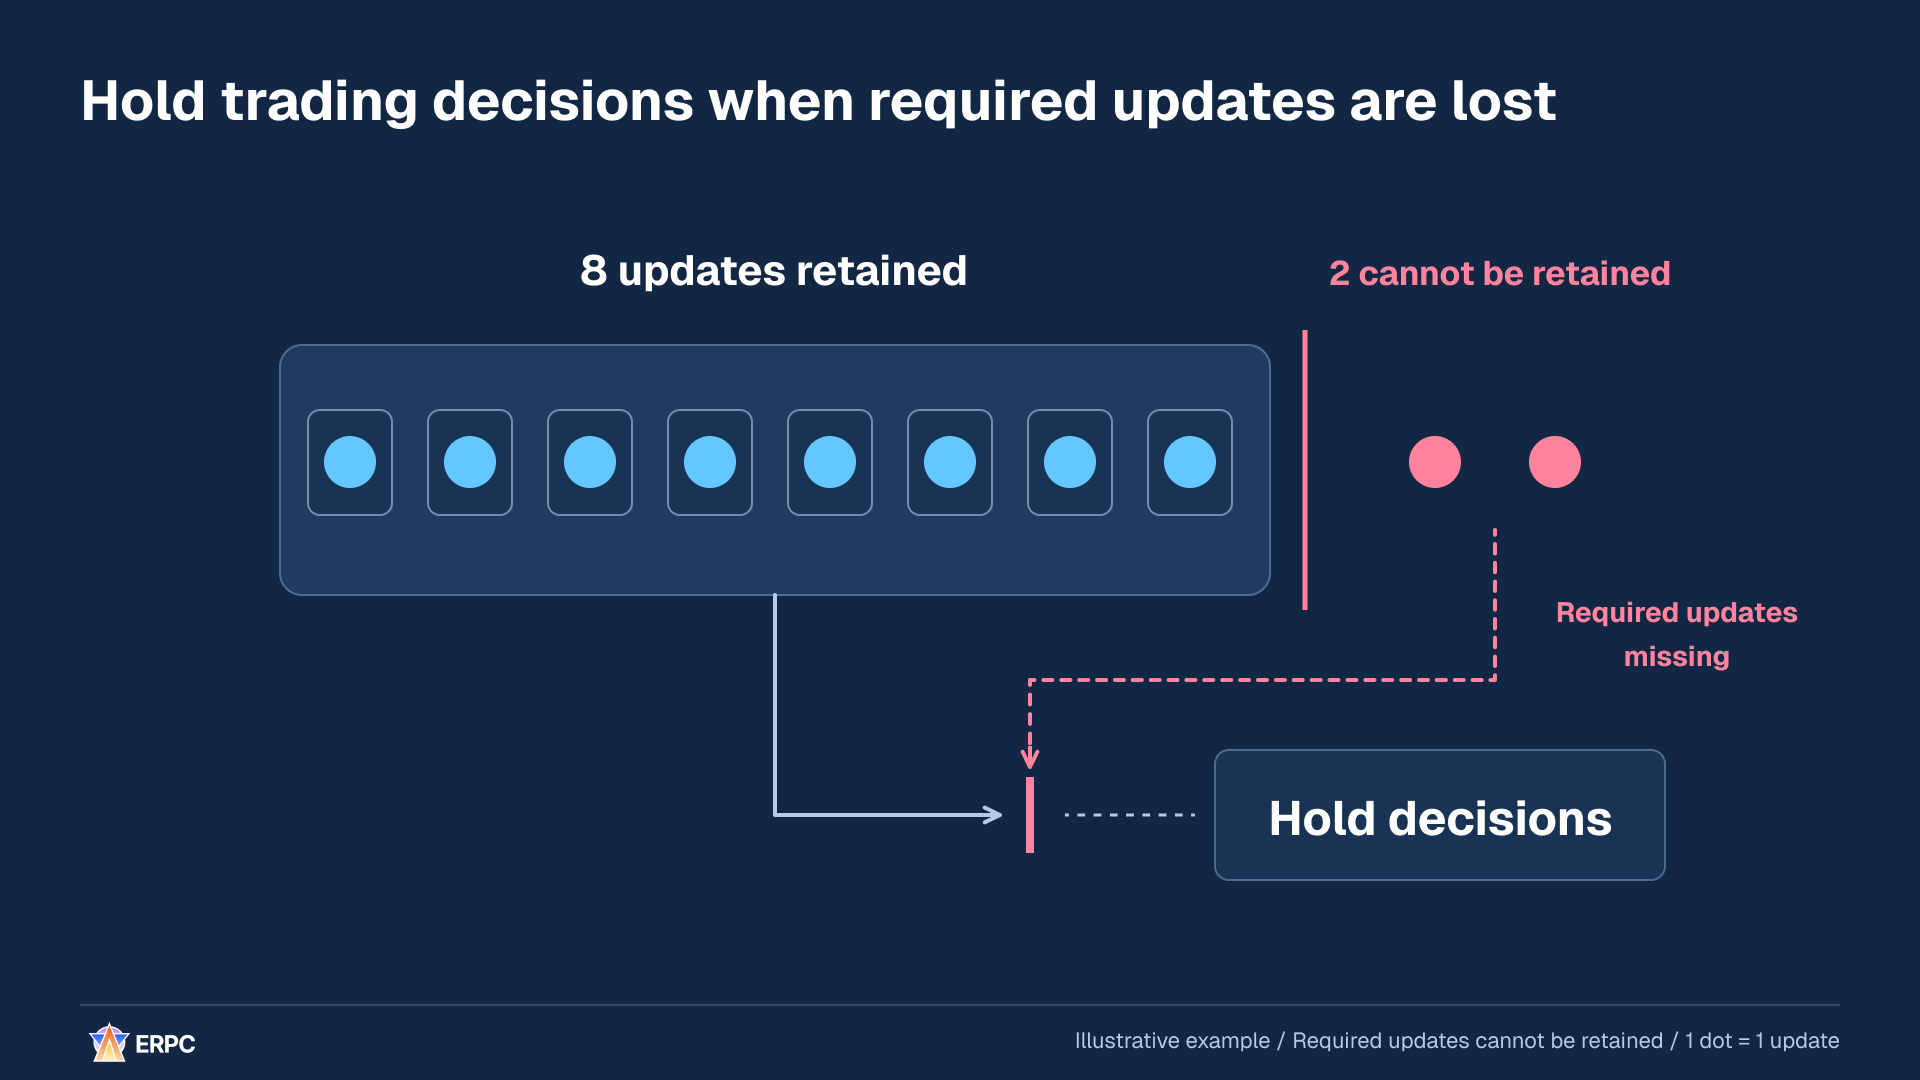
Een wachtrijontwerp moet ook vastleggen wat er na het bereiken van de grens gebeurt.
Onderzoek of je de hoeveelheid werk kunt verkleinen of de verwerkingscapaciteit kunt vergroten. Als een afnemer alleen de meest recente volledige toestand van dezelfde entiteit nodig heeft, kunnen tussenliggende waarden soms worden samengevoegd tot de nieuwste waarde. Bij een proces dat verschillen optelt of tussenliggende gebeurtenissen nodig heeft, verandert het weglaten van updates echter het resultaat.
Het pauzeren van de ontvangst kan de wachttijd ook naar de verzendende kant verplaatsen. Beschouw gRPC flow control, dat het tempo van verzenden en ontvangen regelt, samen met filters aan de serverkant die de geabonneerde data beperken en met de werkelijke verwerkingscapaciteit van de applicatie.[3][4]
Kopieer deze instructies om opstoppingen in de ontvangende wachtrij en de actualiteit van de data te verbeteren.
text
Verbeter de verwerking van binnenkomende data in deze applicatie wanneer de verwerking achterblijft en de data voor beslissingen veroudert.

Lees de README, ontwikkelinstructies, afhankelijkheden en de code voor ontvangst → wachtrij → toestandsupdate → beslissing. Werk met de bestaande taal, runtime en SDK. Stel vast of updates een volledige toestand of verschillen bevatten, in welke volgorde ze moeten worden toegepast en welke actualiteit vereist is.

1. Bewaar reproduceerbare invoer zonder vertrouwelijke informatie en leg de beginsituatie vast. Onderzoek ook wachttijd vóór opname in de wachtrij. Meet over hetzelfde interval het aantal binnenkomende en uitgaande items en bytes, het wachtende werk, de ouderdom van het oudste wachtende item en het werk dat wordt uitgevoerd.
2. Bepaal en implementeer grenzen voor items, bytes, wachttijd en gelijktijdige uitvoering, met een reden voor elke grens. Benoem aannames waar vereisten onbekend zijn. Controleer of onnodige ontvangst of verwerking kan worden verminderd en of de verwerkingscapaciteit toereikend is. Beschouw alleen een grotere wachtrij niet als oplossing voor een aanhoudend tekort aan verwerkingscapaciteit.
3. Bepaal wat er gebeurt als de wachtrij vol is. Pauzeer nieuwe handelsbeslissingen die van de betrokken waarden afhangen wanneer noodzakelijke updates niet kunnen worden behouden, of wanneer de vereiste actualiteit verloren gaat zonder dat updates ontbreken. Ga verder met toestandsupdates en herstel en controleer de voorwaarden voor hervatting.
4. Als je tussenliggende waarden samenvoegt, stel dan vast dat de meest recente volledige toestand van dezelfde entiteit volstaat om het resultaat te behouden. Gooi noodzakelijke verschillen of gebeurtenissen niet stilzwijgend weg. Controleer bij het pauzeren van ontvangst het gedrag van de stroomregeling van de aanbieder en waar de wachttijd terechtkomt.
5. Speel normale invoer, pieken, aanhoudende overbelasting en herstel na een volle wachtrij af onder overeenkomstige voorwaarden. Vergelijk aankomst- en verwerkingssnelheid, ouderdom van het oudste item, p50/p95/p99 van ontvangst tot beslissing, CPU en geheugen en ontbrekende of weggegooide updates. Vergelijk de toegepaste toestand en beslissingen met de verwachte resultaten. Gebruik binnen één host een monotone klok voor verstreken tijd en geef het begin- en eindpunt van de meting aan.

Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.

Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.
Verbeter de verwerking van binnenkomende data in deze applicatie wanneer de verwerking achterblijft en de data voor beslissingen veroudert.
Lees de README, ontwikkelinstructies, afhankelijkheden en de code voor ontvangst → wachtrij → toestandsupdate → beslissing. Werk met de bestaande taal, runtime en SDK. Stel vast of updates een volledige toestand of verschillen bevatten, in welke volgorde ze moeten worden toegepast en welke actualiteit vereist is.
1. Bewaar reproduceerbare invoer zonder vertrouwelijke informatie en leg de beginsituatie vast. Onderzoek ook wachttijd vóór opname in de wachtrij. Meet over hetzelfde interval het aantal binnenkomende en uitgaande items en bytes, het wachtende werk, de ouderdom van het oudste wachtende item en het werk dat wordt uitgevoerd.
2. Bepaal en implementeer grenzen voor items, bytes, wachttijd en gelijktijdige uitvoering, met een reden voor elke grens. Benoem aannames waar vereisten onbekend zijn. Controleer of onnodige ontvangst of verwerking kan worden verminderd en of de verwerkingscapaciteit toereikend is. Beschouw alleen een grotere wachtrij niet als oplossing voor een aanhoudend tekort aan verwerkingscapaciteit.
3. Bepaal wat er gebeurt als de wachtrij vol is. Pauzeer nieuwe handelsbeslissingen die van de betrokken waarden afhangen wanneer noodzakelijke updates niet kunnen worden behouden, of wanneer de vereiste actualiteit verloren gaat zonder dat updates ontbreken. Ga verder met toestandsupdates en herstel en controleer de voorwaarden voor hervatting.
4. Als je tussenliggende waarden samenvoegt, stel dan vast dat de meest recente volledige toestand van dezelfde entiteit volstaat om het resultaat te behouden. Gooi noodzakelijke verschillen of gebeurtenissen niet stilzwijgend weg. Controleer bij het pauzeren van ontvangst het gedrag van de stroomregeling van de aanbieder en waar de wachttijd terechtkomt.
5. Speel normale invoer, pieken, aanhoudende overbelasting en herstel na een volle wachtrij af onder overeenkomstige voorwaarden. Vergelijk aankomst- en verwerkingssnelheid, ouderdom van het oudste item, p50/p95/p99 van ontvangst tot beslissing, CPU en geheugen en ontbrekende of weggegooide updates. Vergelijk de toegepaste toestand en beslissingen met de verwachte resultaten. Gebruik binnen één host een monotone klok voor verstreken tijd en geef het begin- en eindpunt van de meting aan.
Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.
Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.2. Verwerk de volgende prijs zonder op het opslaan van een record te wachten
Neem een marktprijs die van 100 naar 101 verandert. De applicatie heeft 100 verwerkt, haar beslissing afgerond en slaat nu een analytisch record op. Als de lus die binnenkomende data afhandelt op die opslag wacht, kan ze 101 niet toepassen wanneer die update binnenkomt. De opgeslagen prijs blijft 100.
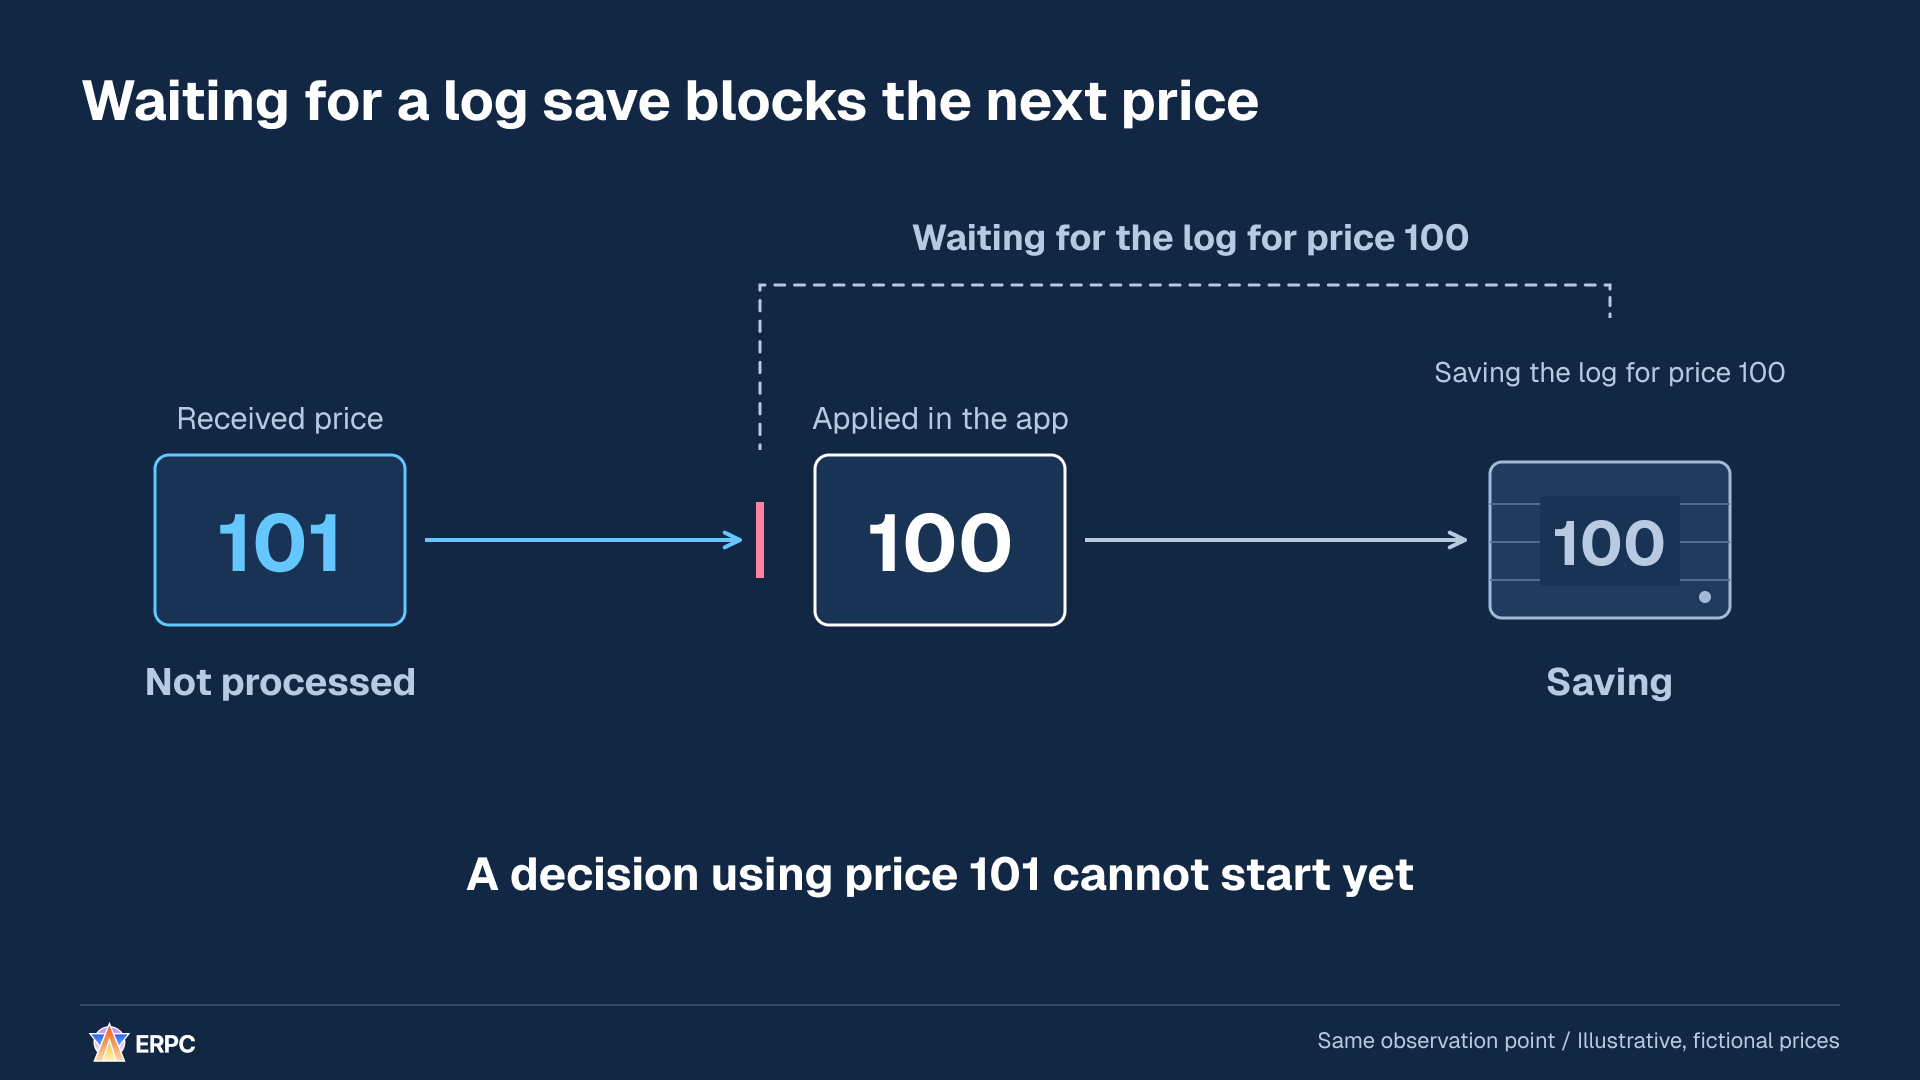
De verwerking van 101 kan niet beginnen doordat ze wacht op het record van 100.
Geef het analytische record nu door aan een hulpwachtrij met vrije ruimte en laat een afzonderlijke bewerking het opslaan. De ontvangende lus kan na de overdracht terugkeren naar de volgende invoer. Ze kan 101 toepassen en een beslissing nemen terwijl de opslag van 100 nog bezig is.
In de volgende vergelijking blijven de opslagduur van 100, het aankomstmoment van 101 en de verwerkingstijd van 101 gelijk. Alleen de afhankelijkheid tussen doorgaan naar de volgende invoer en het afronden van de opslag verandert.
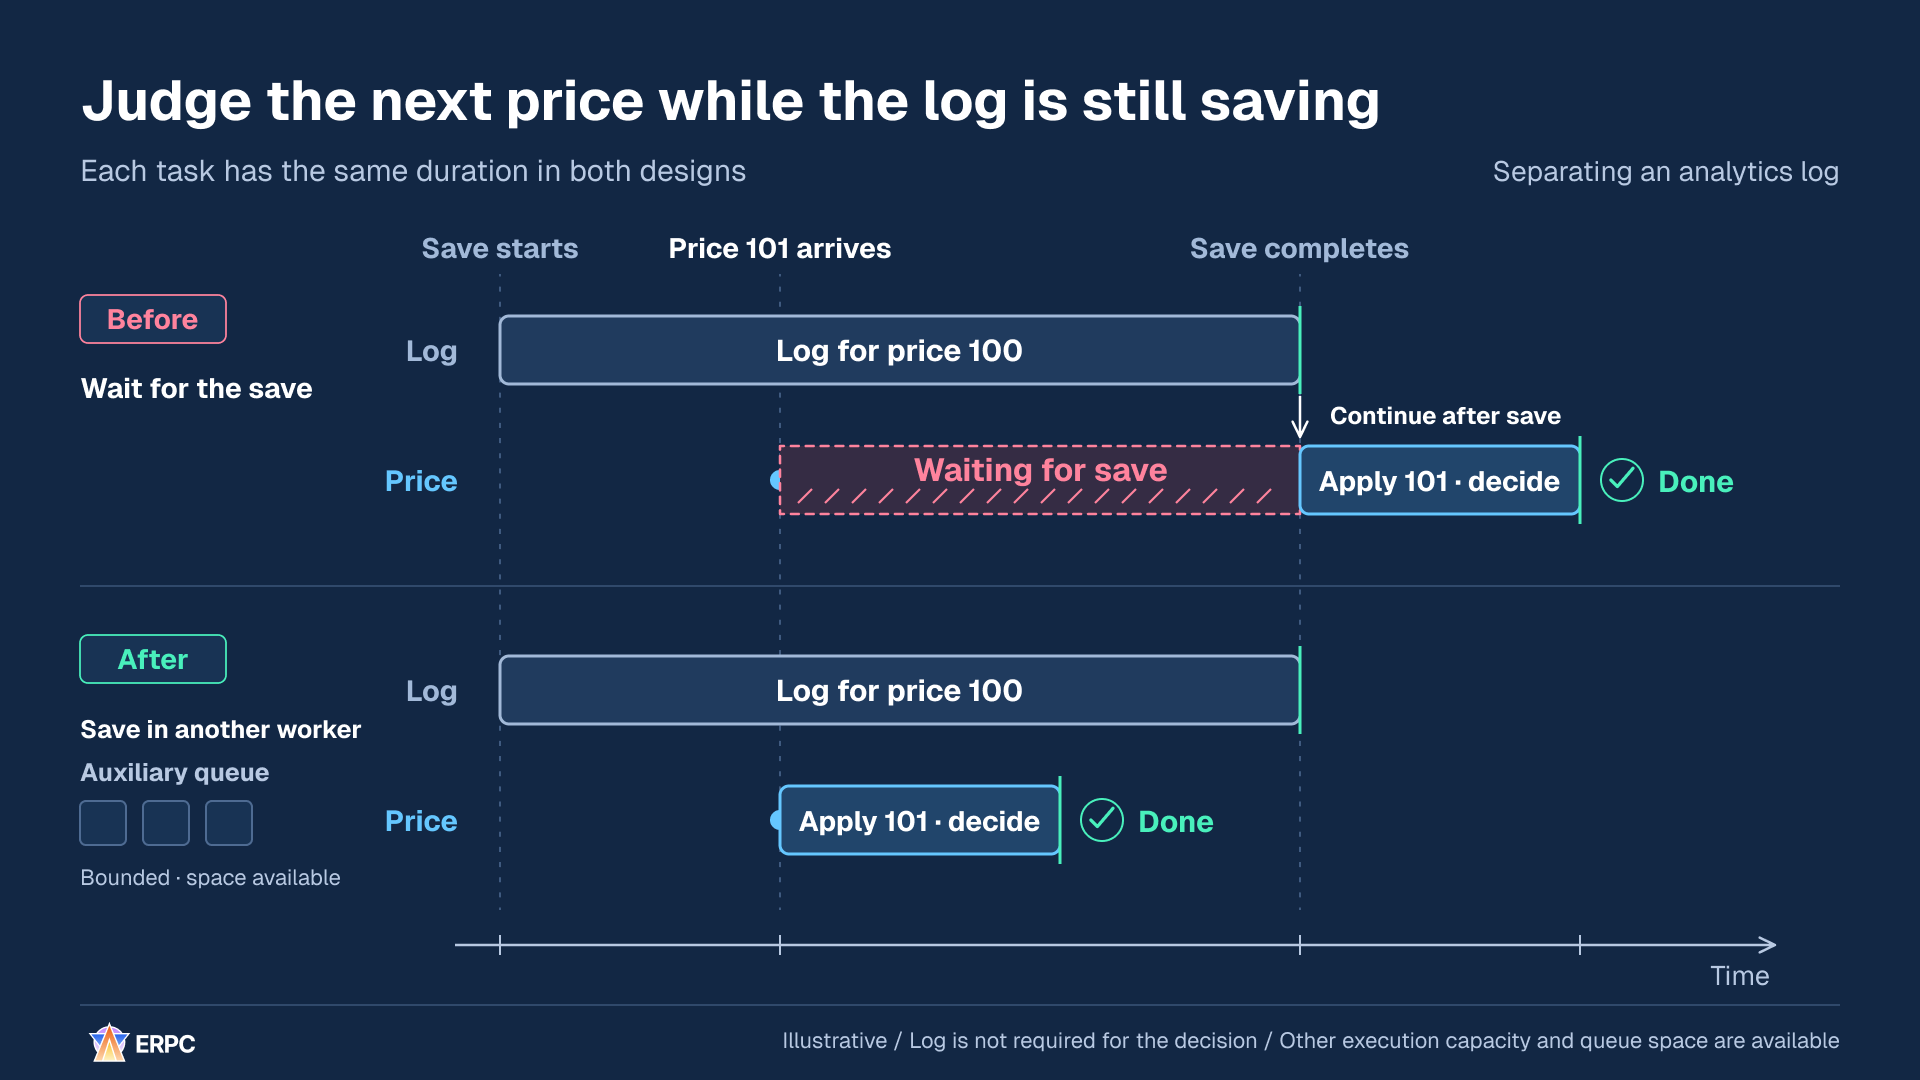
Ook zonder het werk voor 101 zelf te verkorten, kun je het wachten vóór de start verminderen.
Het verwerkingspad dat nodig is vanaf ontvangst tot en met beslissing en verzending heet de hot path. In dit voorbeeld wordt analytische logging die de beslissing niet hoeft op te houden, buiten dat pad geplaatst. Saldocontroles, controles op risicolimieten en opslag die voor de correctheid afgerond moet zijn, blijven staan waar de eisen dat vereisen.
Het opslagwerk blijft bestaan, dus ook de hulpwachtrij heeft grenzen aan capaciteit en wachttijd nodig. Een afzonderlijke taak draait niet noodzakelijk op een afzonderlijke CPU. Lange CPU-intensieve of blokkerende bewerkingen in Tokio en lange synchrone bewerkingen op de event loop van Node.js kunnen ander werk tegenhouden. Controleer bij het verplaatsen van werk waar het daadwerkelijk wordt uitgevoerd.[1][2]
Kopieer deze instructies om wachten op analytische opslag van het beslissingspad te scheiden.
text
Verbeter deze applicatie waar het wachten op het opslaan van analytische records verhindert dat de volgende update wordt toegepast of voor een beslissing wordt gebruikt.

Lees de README, ontwikkelinstructies, afhankelijkheden en ontvangende lus. Werk met de bestaande taal, runtime en opslagbibliotheek. Zoek waar wordt gewacht op voltooiing van opslag en bepaal in welke threads, taken of event loops het werk daadwerkelijk draait.

1. Bereid reproduceerbare invoer zonder vertrouwelijke informatie voor. Leg ontvangst, toepassing op de toestand, begin en afronding van beslissingen, begin en afronding van opslag en de huidige resultaten vast.
2. Stel vanuit de vereisten vast of voltooide opslag een voorwaarde voor beslissingen of herstel is. Houd saldocontroles, risicocontroles en voor correctheid noodzakelijke persistente opslag op de vereiste plaats. Scheid analytische records waarvan de opslag later mag worden afgerond.
3. Bepaal hoe records worden overgedragen zodat latere toestandswijzigingen de vast te leggen waarden niet kunnen veranderen. Implementeer een begrensde hulpwachtrij en een verwerker die de records opslaat. Specificeer grenzen voor items, bytes en wachttijd; gedrag bij een volle wachtrij, opslagfouten, nieuwe pogingen en afsluiten; en bewaareisen. Gooi geen records weg zolang de bewaareisen onbekend zijn.
4. Ga er niet van uit dat een aparte taak op een andere CPU draait. Controleer waar synchrone I/O en langdurig CPU-werk worden uitgevoerd. Beperk bij workers of vergelijkbare voorzieningen de gelijktijdige uitvoering en neem conversie, kopiëren en wachten op overdracht mee in de beoordeling.
5. Gebruik dezelfde invoer en hetzelfde aankomsttempo om normale opslag, trage opslag, fouten, een volle hulpwachtrij en afsluiten te reproduceren. Vergelijk p50/p95/p99 van ontvangst tot beslissing, wachttijd en achterstand aan de opslagkant, CPU en geheugen en ontbrekende of dubbele records. Controleer de juistheid van toestand en beslissingen en de bewaareisen voor records. Gebruik binnen één host een monotone klok voor verstreken tijd en geef het begin- en eindpunt van de meting aan.

Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.

Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.
Verbeter deze applicatie waar het wachten op het opslaan van analytische records verhindert dat de volgende update wordt toegepast of voor een beslissing wordt gebruikt.
Lees de README, ontwikkelinstructies, afhankelijkheden en ontvangende lus. Werk met de bestaande taal, runtime en opslagbibliotheek. Zoek waar wordt gewacht op voltooiing van opslag en bepaal in welke threads, taken of event loops het werk daadwerkelijk draait.
1. Bereid reproduceerbare invoer zonder vertrouwelijke informatie voor. Leg ontvangst, toepassing op de toestand, begin en afronding van beslissingen, begin en afronding van opslag en de huidige resultaten vast.
2. Stel vanuit de vereisten vast of voltooide opslag een voorwaarde voor beslissingen of herstel is. Houd saldocontroles, risicocontroles en voor correctheid noodzakelijke persistente opslag op de vereiste plaats. Scheid analytische records waarvan de opslag later mag worden afgerond.
3. Bepaal hoe records worden overgedragen zodat latere toestandswijzigingen de vast te leggen waarden niet kunnen veranderen. Implementeer een begrensde hulpwachtrij en een verwerker die de records opslaat. Specificeer grenzen voor items, bytes en wachttijd; gedrag bij een volle wachtrij, opslagfouten, nieuwe pogingen en afsluiten; en bewaareisen. Gooi geen records weg zolang de bewaareisen onbekend zijn.
4. Ga er niet van uit dat een aparte taak op een andere CPU draait. Controleer waar synchrone I/O en langdurig CPU-werk worden uitgevoerd. Beperk bij workers of vergelijkbare voorzieningen de gelijktijdige uitvoering en neem conversie, kopiëren en wachten op overdracht mee in de beoordeling.
5. Gebruik dezelfde invoer en hetzelfde aankomsttempo om normale opslag, trage opslag, fouten, een volle hulpwachtrij en afsluiten te reproduceren. Vergelijk p50/p95/p99 van ontvangst tot beslissing, wachttijd en achterstand aan de opslagkant, CPU en geheugen en ontbrekende of dubbele records. Controleer de juistheid van toestand en beslissingen en de bewaareisen voor records. Gebruik binnen één host een monotone klok voor verstreken tijd en geef het begin- en eindpunt van de meting aan.
Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.
Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.3. Laat onafhankelijke updates niet op dezelfde lock wachten
Stel dat een applicatie de prijzen van markten A en B onafhankelijk kan bijwerken. Een update voor B komt binnen nadat de update voor A is begonnen. Als één mutex zowel A als B beschermt, moet B wachten tot A die lock vrijgeeft.
Een mutex geeft telkens één bewerking het recht om de beschermde data te gebruiken. Als een andere bewerking de mutex gebruikt, wacht een bewerking die dezelfde lock probeert te verkrijgen.[17]
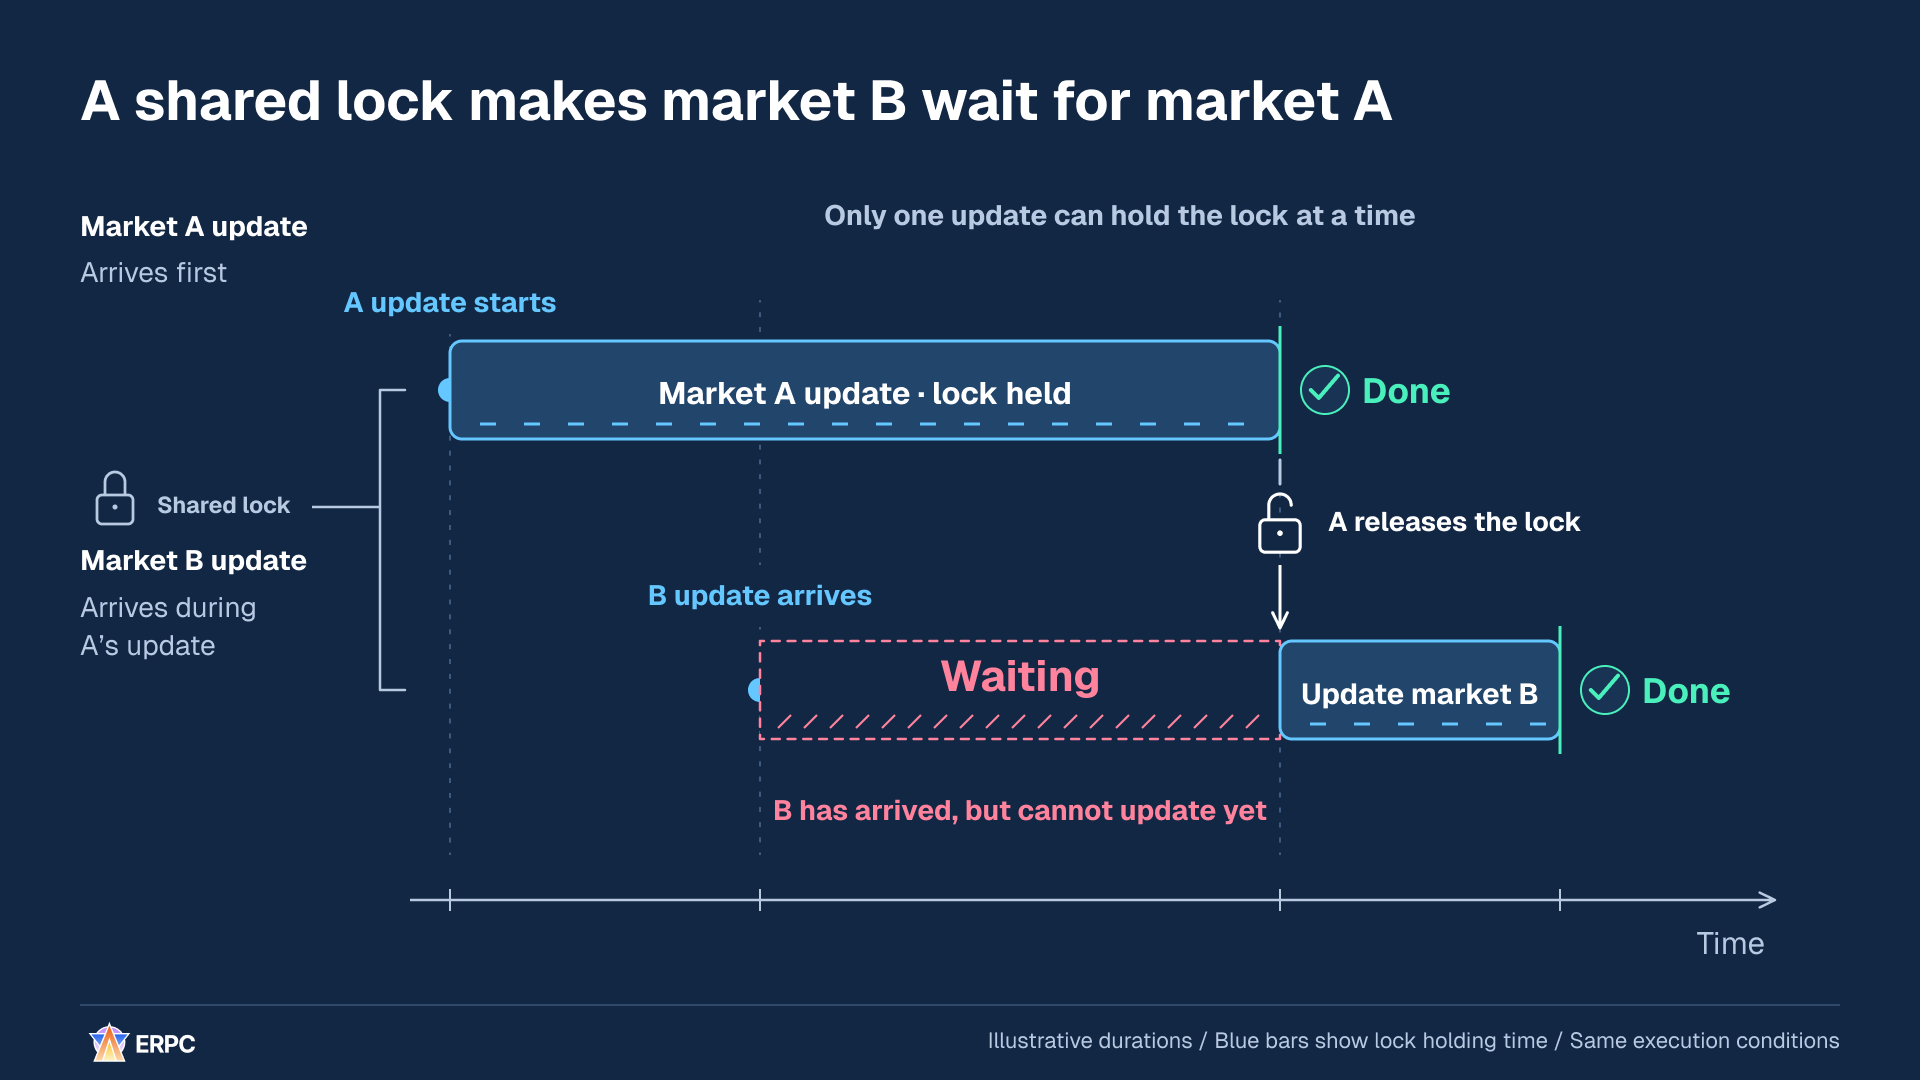
De data van B is binnen, maar wacht op de gedeelde lock die A vasthoudt.
Als A en B elk afzonderlijke waarden wijzigen, kun je ze met afzonderlijke locks beschermen. De bovenste helft van het volgende diagram gebruikt een gedeelde lock; de onderste helft afzonderlijke locks. De aankomstmomenten en de duur waarin A en B hun lock vasthouden, zijn in beide helften gelijk. Het voorbeeld veronderstelt dat de lock van B vrij is en dat er uitvoeringscapaciteit voor B beschikbaar is. De officiële Tokio-tutorial beschrijft ook het opsplitsen van mutexen voor data met onafhankelijke sleutels.[18]
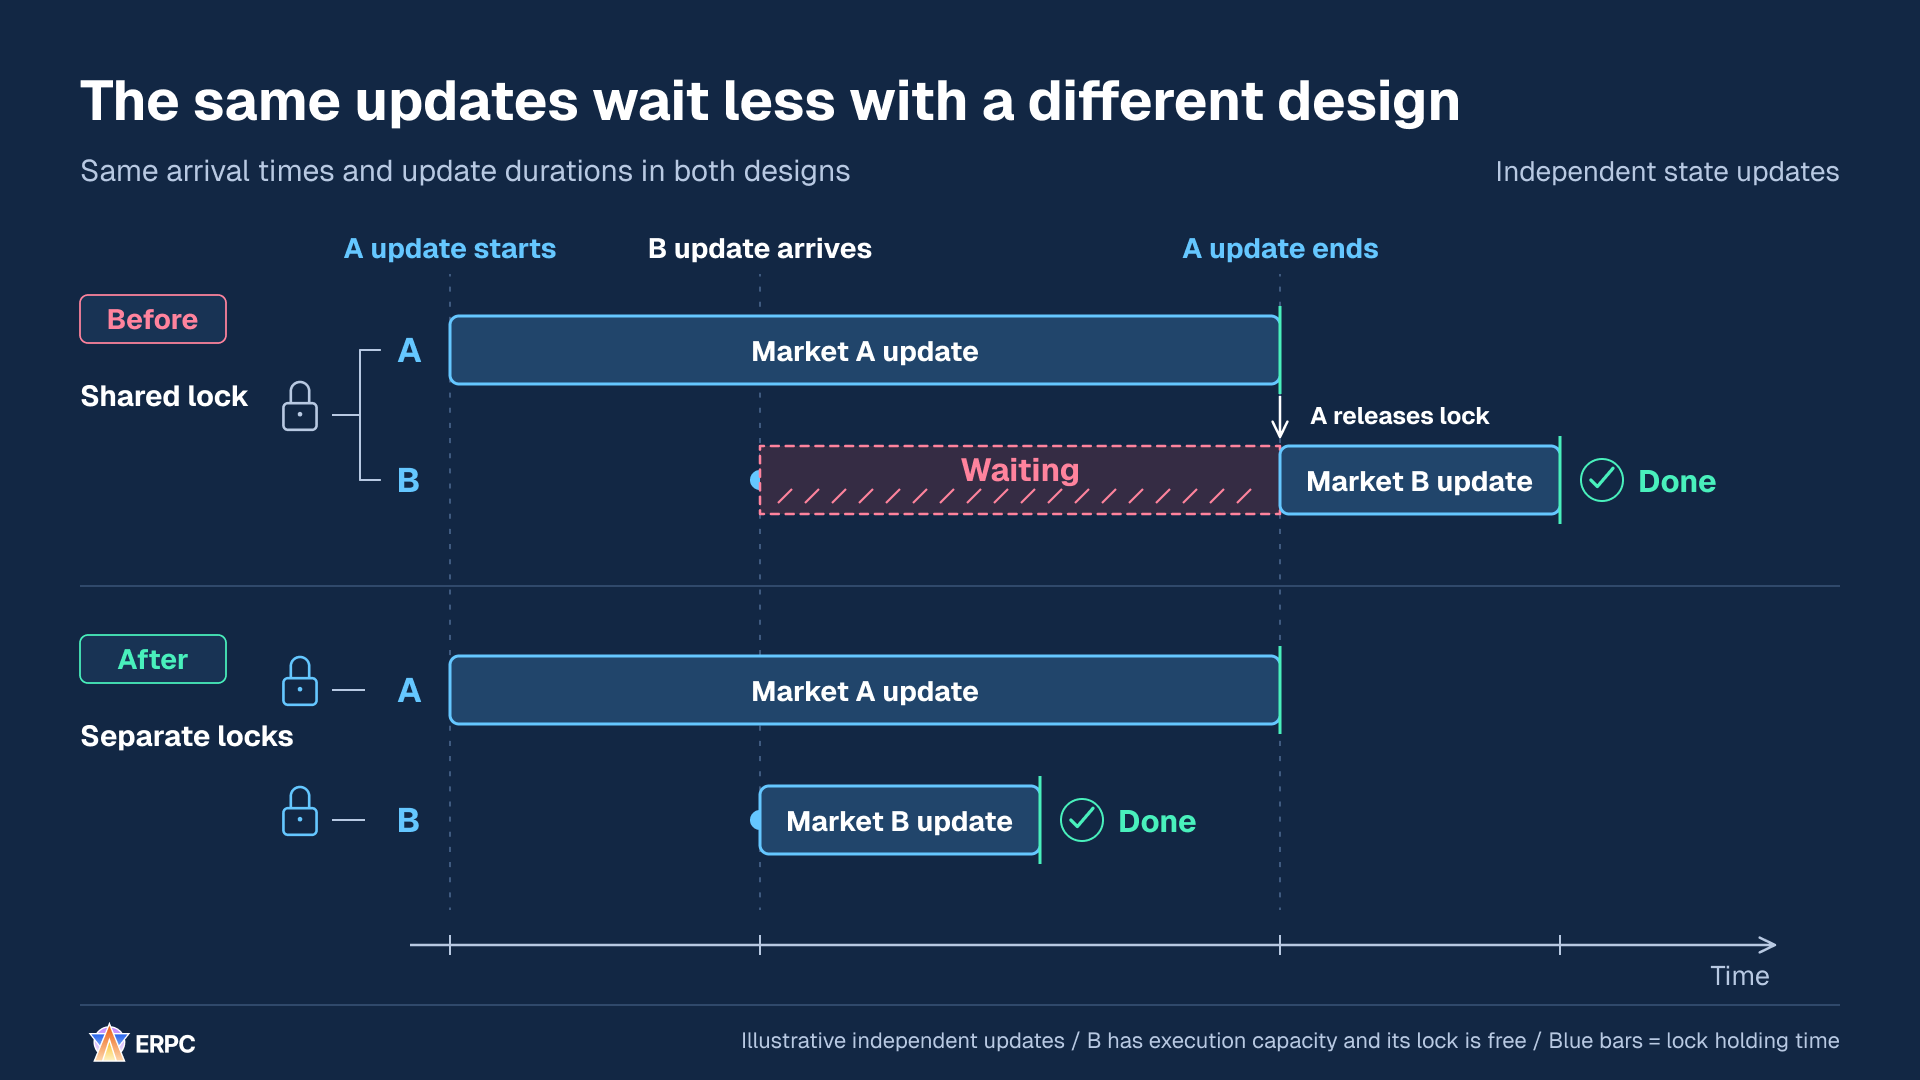
De blauwe balk van B is even lang. Het verdwenen deel is het roze wachtinterval ervoor.
De blauwe balk loopt van het verkrijgen tot het vrijgeven van de lock. In dit voorbeeld is B klaar terwijl A nog bezig is met bijwerken. Afzonderlijke locks nemen geen wachttijd weg die ontstaat doordat B's eigen lock bezet is of ander werk de beschikbare uitvoeringscapaciteit gebruikt.
Stel vóór het opsplitsen vast welke updates onafhankelijk zijn. Ook als de prijzen van A en B afzonderlijk kunnen worden bijgewerkt, moet een beslissing die beide prijzen of een gedeeld saldo gebruikt de vereiste waarden consistent kunnen lezen. Waarden kunnen veranderen terwijl een bewerking bij een await is onderbroken, zelfs op dezelfde thread. Leg vast welke versies een beslissing leest, hoe ze die leest en in welke volgorde updates worden toegepast.
Als A en B bijvoorbeeld hetzelfde saldo lezen en elk een order opbouwen, kunnen ze allebei op hetzelfde geld rekenen. Gedeelde waarden hebben nog steeds eigen bescherming nodig, bijvoorbeeld één verantwoordelijke die het saldo controleert en het geld voor elke order achtereenvolgens reserveert.
Een andere mogelijkheid is om elke toestand één verantwoordelijke voor updates te geven en daar updateberichten naartoe te sturen. Dat is het Single Writer-principe. Locks opsplitsen en één schrijver kiezen zijn afzonderlijke ontwerpbeslissingen. LMAX Disruptor beschrijft Single Writer en verwerkingsafhankelijkheden; Tokio beschrijft toestandsbeheer via berichten aan een specifieke taak.[5][18]
Kopieer deze instructies om lockwachttijd tussen onafhankelijke updates te verminderen.
text
Verbeter deze applicatie waar een update voor één markt of sleutel een onafhankelijke update op dezelfde gedeelde lock laat wachten.

Lees de README, ontwikkelinstructies, afhankelijkheden en code die toestand leest of schrijft, locks verkrijgt of met await op ander werk wacht. Gebruik de bestaande taal en runtime. Bepaal wie elke waarde bijwerkt en welke verzamelingen waarden elke beslissing leest.

1. Bewaar reproduceerbare invoer zonder vertrouwelijke informatie en leg de beginsituatie vast. Registreer bij locks met concurrentie de aankomsten per sleutel, wachttijd voor verkrijging, vasthoudtijd, updatevolgorde en toestandsversies die voor beslissingen worden gebruikt.
2. Maak onderscheid tussen waarden die onafhankelijk kunnen worden bijgewerkt en waarden waarvan de consistentie samen moet worden beschermd. Splits locks rond onafhankelijke toestand en maak per sleutel de toepassingsvolgorde en schrijfverantwoordelijkheid expliciet. Houd het aantal locks of verantwoordelijke verwerkers onder controle.
3. Bescherm beslissingen over meerdere markten en gedeelde saldi of reserveringen van middelen. Maak saldocontrole en reservering één gecoördineerde bewerking, zodat meerdere orders niet elk kunnen aannemen dat dezelfde middelen beschikbaar zijn. Leg een verkrijgingsvolgorde vast als meerdere locks nodig zijn.
4. Onderzoek toestandswijzigingen over await-punten heen en de voltooiingsvolgorde bij parallel decoderen. Definieer welke versies een beslissing leest en hoe zij die leest. Laat de voltooiingsvolgorde van decoderen niet de vereiste toepassingsvolgorde vervangen. Controleer na het splitsen of beperkte uitvoeringsresources of concurrentie op dezelfde sleutel nog wachttijd veroorzaken.
5. Speel dezelfde invoer en aankomstvolgorde af met onafhankelijke sleutels, geconcentreerde updates op één sleutel, concurrerende reserveringen van gedeelde middelen en onderbroken en hervat werk. Vergelijk lockwachttijd, p50/p95/p99 van ontvangst tot beslissing, CPU en geheugen. Controleer de vereiste updatevolgorde, consistente toestand voor beslissingen en afwezigheid van dubbele reserveringen. Gebruik binnen één host een monotone klok voor verstreken tijd en geef het begin- en eindpunt van de meting aan.

Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.

Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.
Verbeter deze applicatie waar een update voor één markt of sleutel een onafhankelijke update op dezelfde gedeelde lock laat wachten.
Lees de README, ontwikkelinstructies, afhankelijkheden en code die toestand leest of schrijft, locks verkrijgt of met await op ander werk wacht. Gebruik de bestaande taal en runtime. Bepaal wie elke waarde bijwerkt en welke verzamelingen waarden elke beslissing leest.
1. Bewaar reproduceerbare invoer zonder vertrouwelijke informatie en leg de beginsituatie vast. Registreer bij locks met concurrentie de aankomsten per sleutel, wachttijd voor verkrijging, vasthoudtijd, updatevolgorde en toestandsversies die voor beslissingen worden gebruikt.
2. Maak onderscheid tussen waarden die onafhankelijk kunnen worden bijgewerkt en waarden waarvan de consistentie samen moet worden beschermd. Splits locks rond onafhankelijke toestand en maak per sleutel de toepassingsvolgorde en schrijfverantwoordelijkheid expliciet. Houd het aantal locks of verantwoordelijke verwerkers onder controle.
3. Bescherm beslissingen over meerdere markten en gedeelde saldi of reserveringen van middelen. Maak saldocontrole en reservering één gecoördineerde bewerking, zodat meerdere orders niet elk kunnen aannemen dat dezelfde middelen beschikbaar zijn. Leg een verkrijgingsvolgorde vast als meerdere locks nodig zijn.
4. Onderzoek toestandswijzigingen over await-punten heen en de voltooiingsvolgorde bij parallel decoderen. Definieer welke versies een beslissing leest en hoe zij die leest. Laat de voltooiingsvolgorde van decoderen niet de vereiste toepassingsvolgorde vervangen. Controleer na het splitsen of beperkte uitvoeringsresources of concurrentie op dezelfde sleutel nog wachttijd veroorzaken.
5. Speel dezelfde invoer en aankomstvolgorde af met onafhankelijke sleutels, geconcentreerde updates op één sleutel, concurrerende reserveringen van gedeelde middelen en onderbroken en hervat werk. Vergelijk lockwachttijd, p50/p95/p99 van ontvangst tot beslissing, CPU en geheugen. Controleer de vereiste updatevolgorde, consistente toestand voor beslissingen en afwezigheid van dubbele reserveringen. Gebruik binnen één host een monotone klok voor verstreken tijd en geef het begin- en eindpunt van de meting aan.
Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.
Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.4. Bereid onveranderlijke onderdelen vooraf voor om werk na ontvangst te verminderen
Stel dat de applicatie bij elke prijsupdate dezelfde vaste ID parseert, uit dezelfde invoer een vast adres afleidt en werkgeheugen reserveert. Dat werkgeheugen wordt ook een buffer genoemd. Door deze drie voorbereidingen telkens te herhalen, komt de tijd voor het voorbereiden van onveranderde informatie op het pad naar elke beslissing terecht.
Voorbereiding waarvan de invoer niet verandert, kan vóór de aankomst van data plaatsvinden en daarna worden hergebruikt. Na ontvangst controleert de applicatie wat bij deze gebeurtenis is veranderd, bouwt ze het definitieve te verzenden bericht op en ondertekent ze die inhoud.
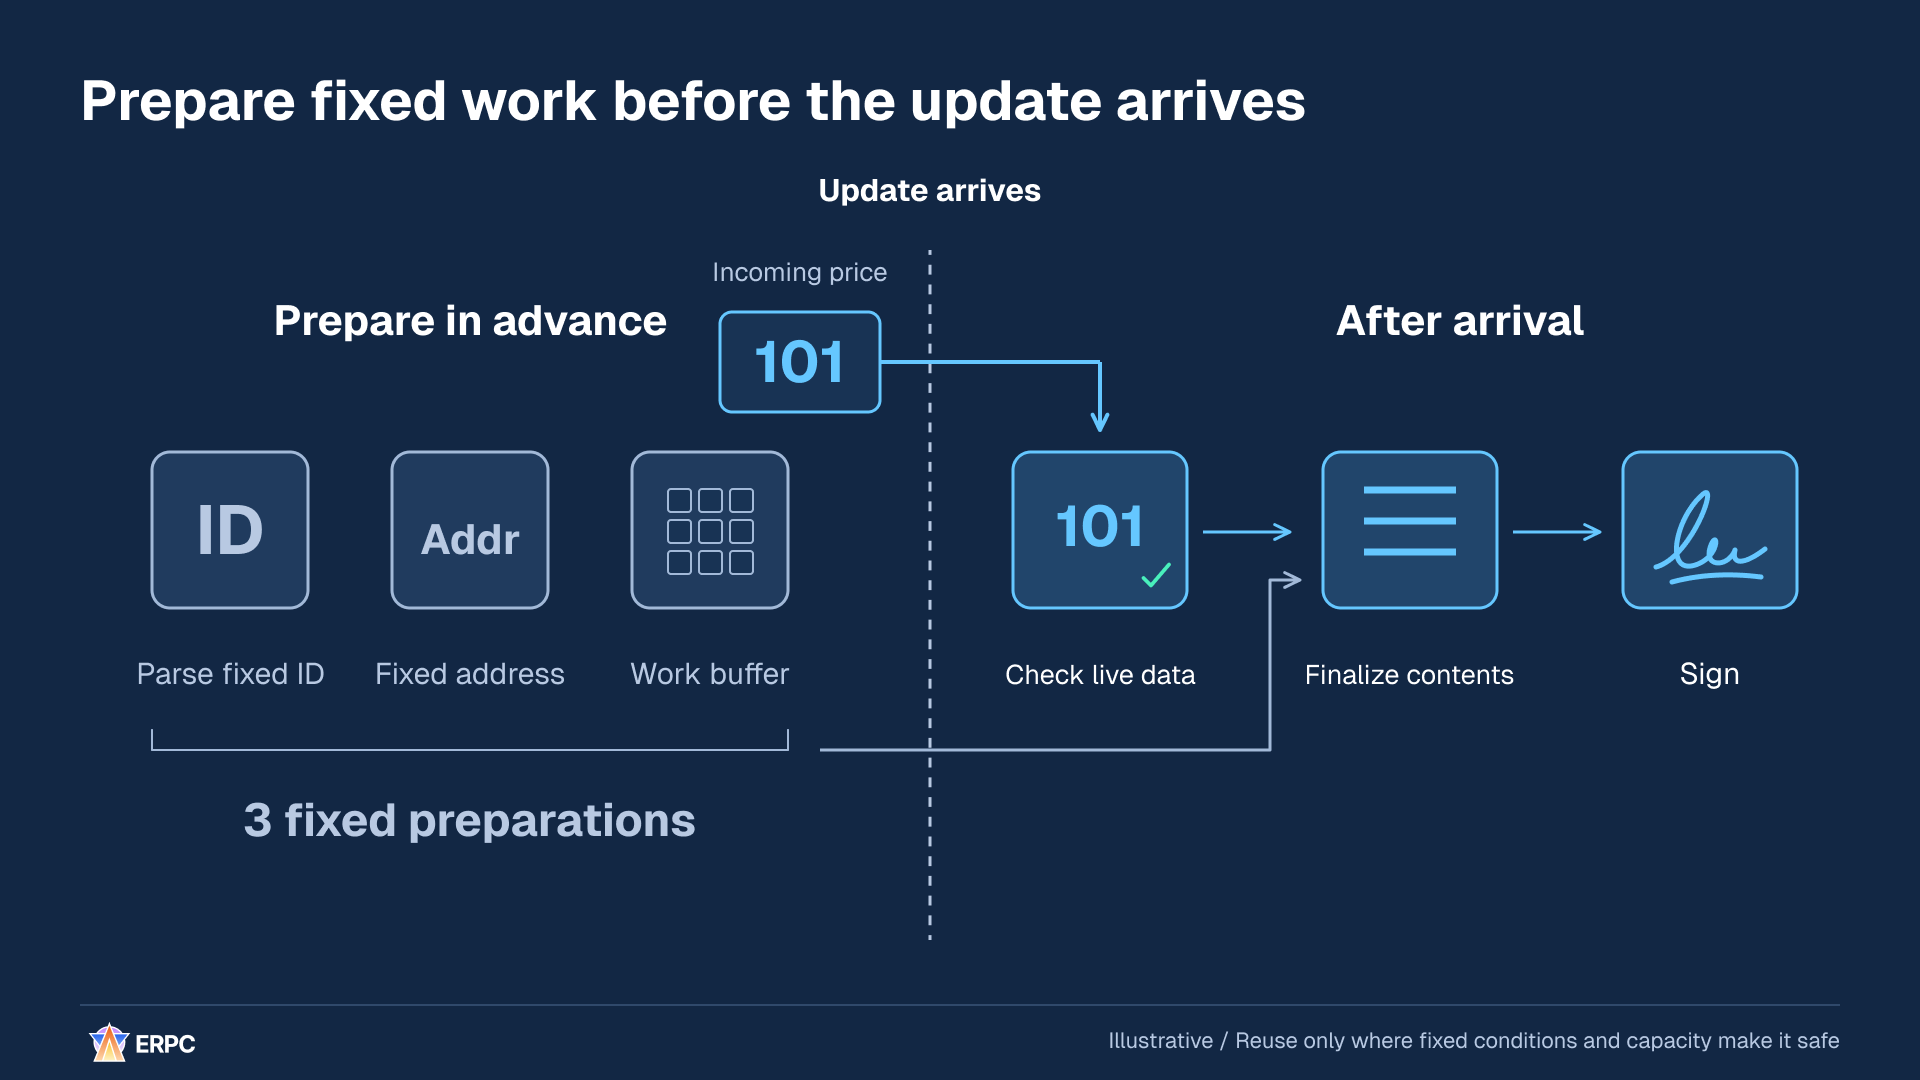
Verplaats onveranderlijke voorbereiding naar voren en behoud de controle van de actuele inhoud en de ondertekening na ontvangst.
Tel wat er voor drie updates verandert. Voor elke gebeurtenis drie soorten onderdelen voorbereiden kost negen voorbereidingsbewerkingen. Die drie soorten één keer voorbereiden en daarna achtereenvolgens hergebruiken kost er drie. Beide ontwerpen ontvangen nog steeds drie gebeurtenissen, verwerken ze één voor één en leveren drie resultaten op.
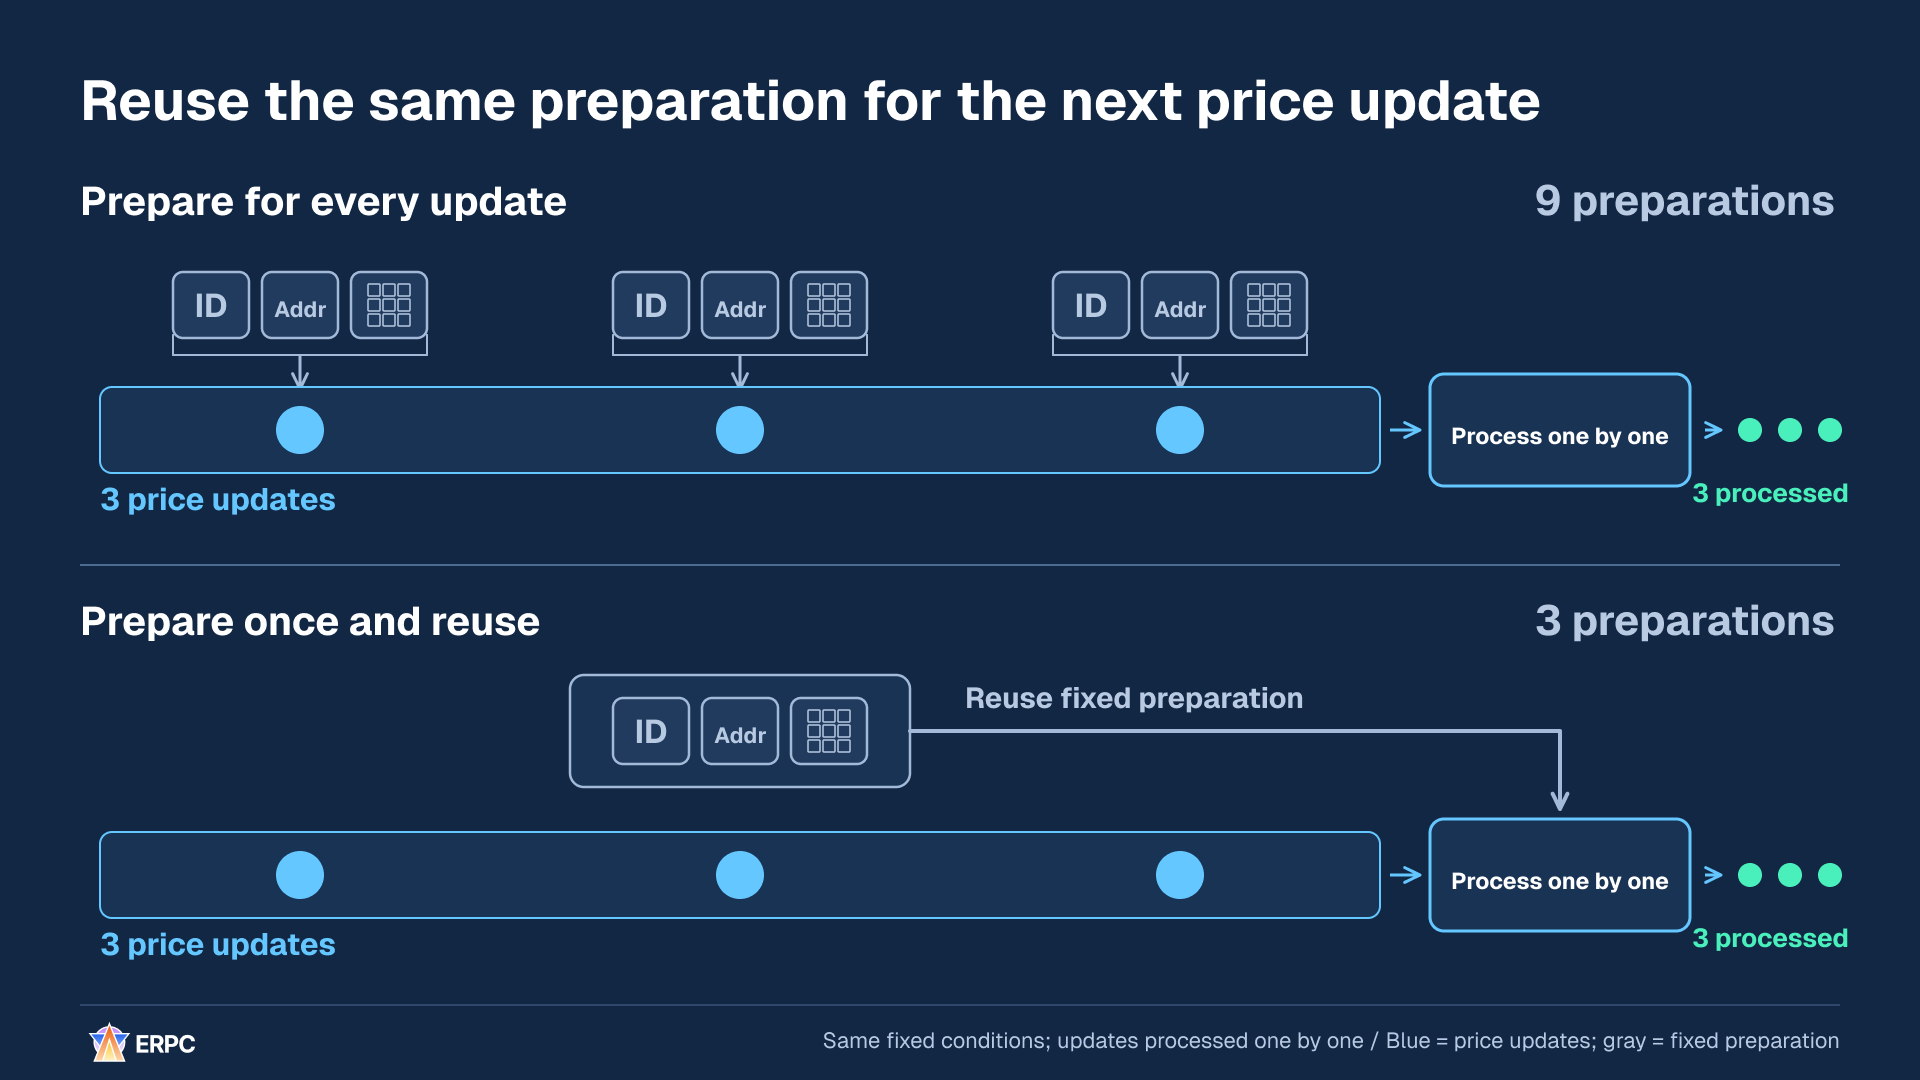
Het aantal gebeurtenissen blijft drie, terwijl de vaste voorbereiding in dit voorbeeld van negen naar drie bewerkingen daalt.
Deze vergelijking veronderstelt dat de vaste voorwaarden niet veranderen en het werkgeheugen veilig achtereenvolgens kan worden hergebruikt. De inhoud wordt nog steeds telkens bijgewerkt voor de huidige gebeurtenis. Als meerdere bewerkingen tegelijk lopen, gebruik dan per bewerking afzonderlijke geheugengebieden of een pool die de toegang beheert, zodat ze niet hetzelfde geheugen overschrijven.
Breid hetzelfde voorbeeld uit naar 1.000 gebeurtenissen. Drie soorten onderdelen voorbereiden voor elke gebeurtenis kost 3.000 voorbereidingsbewerkingen; de gedeelde voorbereiding één keer uitvoeren kost er drie. Beide ontwerpen ontvangen 1.000 gebeurtenissen, verwerken die één voor één en leveren 1.000 resultaten op. Houd het aantal voorbereidingen gescheiden van het aantal verwerkte gebeurtenissen.
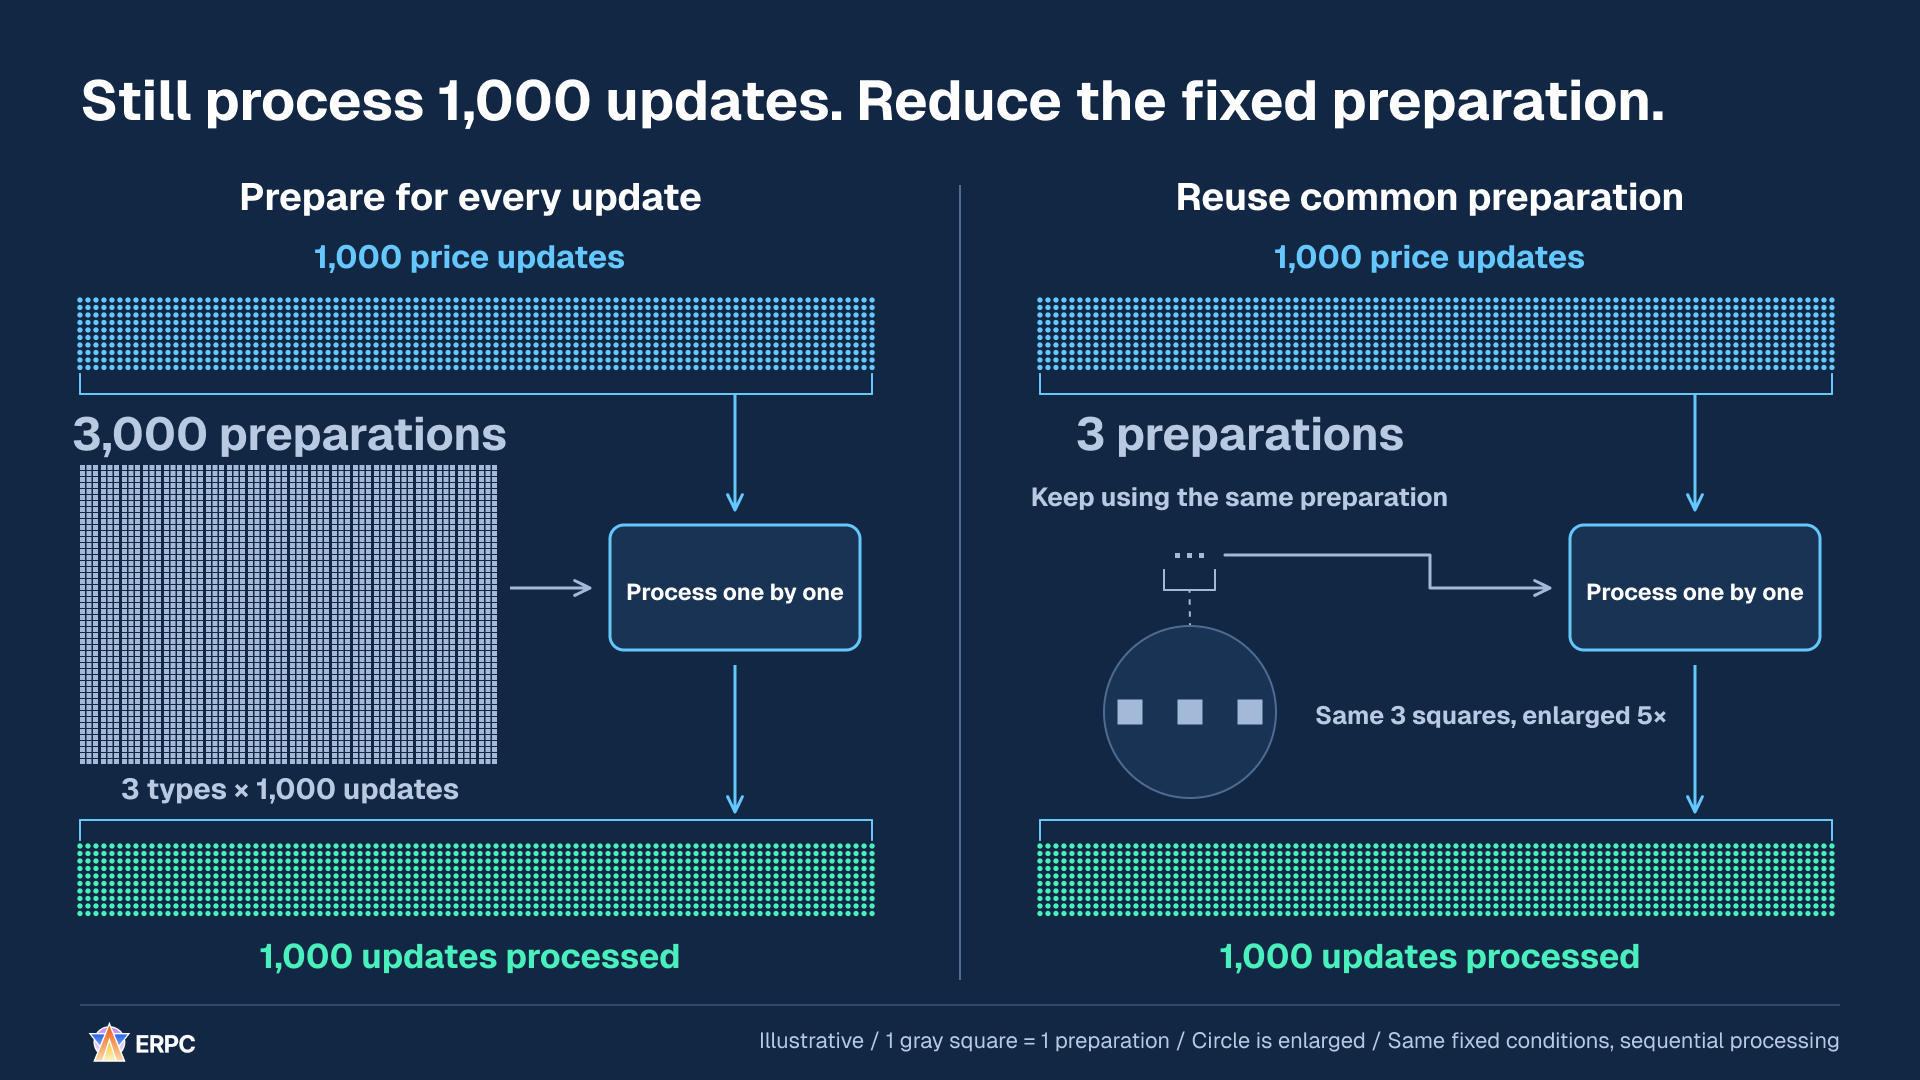
Wat afneemt, is herhaalde vaste voorbereiding. Validatie, beslissingen, ondertekening en ander werk blijven nodig. De verhouding tussen deze aantallen is dus geen versnellingsfactor voor de hele applicatie.
Leg vast onder welke voorwaarden hergebruik geldig blijft. Als een invoer voor het afleiden van het vaste adres verandert, moet het adres opnieuw worden berekend. Prijzen, hoeveelheden, saldi, de toestand van geraadpleegde accounts, risicolimieten en blockhashes moeten geldig zijn wanneer een beslissing ze gebruikt. Als de applicatie voortdurend bijgewerkte lokale toestand bijhoudt, controleer dan de versie, actualiteit en geldigheid. Daarvoor hoeft niet noodzakelijk voor elke beslissing alles opnieuw via RPC te worden opgehaald.
Solana's getLatestBlockhash geeft een blockhash en de bijbehorende lastValidBlockHeight terug. Maak bij het controleren van de vervaldatum onderscheid tussen blokhoogte en slot.[7] Stel het bericht definitief vast voordat je het ondertekent. Als het bericht daarna verandert, maak dan handtekeningen voor de bijgewerkte inhoud.[19]
Kopieer deze instructies om onveranderlijke voorbereiding eerder uit te voeren en te hergebruiken.
text
Onderzoek werk dat bij elke invoer dezelfde ontleding, adresafleiding of geheugenallocatie herhaalt en verplaats herbruikbare voorbereiding naar vóór de ontvangst.

Lees de README, ontwikkelinstructies, afhankelijkheden en de code voor ontvangst → voorbereiding → beslissing → berichtopbouw → ondertekening. Gebruik de bestaande taal, runtime en SDK. Bepaal van elke voorbereiding de invoer, uitvoer, eigenaar en geldigheidsduur.

1. Bewaar reproduceerbare invoer zonder vertrouwelijke informatie. Registreer aantallen gebeurtenissen en uitvoer, uitvoeringsaantal en duur per voorbereiding, gealloceerd geheugen en de tijd van ontvangst tot beslissing.
2. Zoek voorbereiding waarvan de invoer ongewijzigd blijft, voer deze uit tijdens initialisatie of een andere geschikte eerdere fase en hergebruik het resultaat. Implementeer hergebruiksleutels, ongeldigverklaring en herberekening bij wijzigingen in invoer of configuratie en grenzen voor caches en bufferpools.
3. Werk herbruikbaar werkgeheugen bij voor de huidige invoer. Gebruik voor gelijktijdig werk afzonderlijke gebieden of beheerd uitlenen, zodat een gebied niet wordt overschreven of teruggegeven terwijl het nog in gebruik is.
4. Valideer prijzen, hoeveelheden, saldi, accounttoestand, risicovoorwaarden en blockhashes volgens de vereisten van de beslissing. Controleer versie en actualiteit bij gebruik van voortdurend bijgewerkte lokale toestand. Onderscheid bij Solana blokhoogte van slot wanneer je lastValidBlockHeight gebruikt om het verlopen van een blockhash te controleren. Rond het bericht af vóór ondertekening en onderteken het bijgewerkte bericht opnieuw als de inhoud na ondertekening verandert.
5. Vergelijk met dezelfde invoer het aantal en de duur van voorbereidingen, p50/p95/p99 van ontvangst tot beslissing, CPU en geheugen en uitvoer. Reproduceer ook gewijzigde invoer of configuratie, verlopen geldigheid en gelijktijdige uitvoering om hergebruik van verouderde resultaten en geheugenconflicten te controleren. Behandel de verhouding van voorbereidingsaantallen niet als de totale versnelling. Gebruik binnen één host een monotone klok voor verstreken tijd en geef het begin- en eindpunt van de meting aan.

Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.

Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.
Onderzoek werk dat bij elke invoer dezelfde ontleding, adresafleiding of geheugenallocatie herhaalt en verplaats herbruikbare voorbereiding naar vóór de ontvangst.
Lees de README, ontwikkelinstructies, afhankelijkheden en de code voor ontvangst → voorbereiding → beslissing → berichtopbouw → ondertekening. Gebruik de bestaande taal, runtime en SDK. Bepaal van elke voorbereiding de invoer, uitvoer, eigenaar en geldigheidsduur.
1. Bewaar reproduceerbare invoer zonder vertrouwelijke informatie. Registreer aantallen gebeurtenissen en uitvoer, uitvoeringsaantal en duur per voorbereiding, gealloceerd geheugen en de tijd van ontvangst tot beslissing.
2. Zoek voorbereiding waarvan de invoer ongewijzigd blijft, voer deze uit tijdens initialisatie of een andere geschikte eerdere fase en hergebruik het resultaat. Implementeer hergebruiksleutels, ongeldigverklaring en herberekening bij wijzigingen in invoer of configuratie en grenzen voor caches en bufferpools.
3. Werk herbruikbaar werkgeheugen bij voor de huidige invoer. Gebruik voor gelijktijdig werk afzonderlijke gebieden of beheerd uitlenen, zodat een gebied niet wordt overschreven of teruggegeven terwijl het nog in gebruik is.
4. Valideer prijzen, hoeveelheden, saldi, accounttoestand, risicovoorwaarden en blockhashes volgens de vereisten van de beslissing. Controleer versie en actualiteit bij gebruik van voortdurend bijgewerkte lokale toestand. Onderscheid bij Solana blokhoogte van slot wanneer je lastValidBlockHeight gebruikt om het verlopen van een blockhash te controleren. Rond het bericht af vóór ondertekening en onderteken het bijgewerkte bericht opnieuw als de inhoud na ondertekening verandert.
5. Vergelijk met dezelfde invoer het aantal en de duur van voorbereidingen, p50/p95/p99 van ontvangst tot beslissing, CPU en geheugen en uitvoer. Reproduceer ook gewijzigde invoer of configuratie, verlopen geldigheid en gelijktijdige uitvoering om hergebruik van verouderde resultaten en geheugenconflicten te controleren. Behandel de verhouding van voorbereidingsaantallen niet als de totale versnelling. Gebruik binnen één host een monotone klok voor verstreken tijd en geef het begin- en eindpunt van de meting aan.
Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.
Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.5. Blijf geen beslissingen nemen nadat noodzakelijke updates zijn gemist
Neem twee markten voor hetzelfde activum, waarbij de applicatie het prijsverschil B−A berekent. Tijdens een verbindingsonderbreking verandert markt A van 100 naar 105 en mist de applicatie die update. Als ze na het opnieuw verbinden alleen B's prijs van 104 ontvangt, berekent ze 104−100, oftewel +4. Met de bijgewerkte waarde van A wordt dat 104−105, oftewel -1. Zelfs het teken verandert.
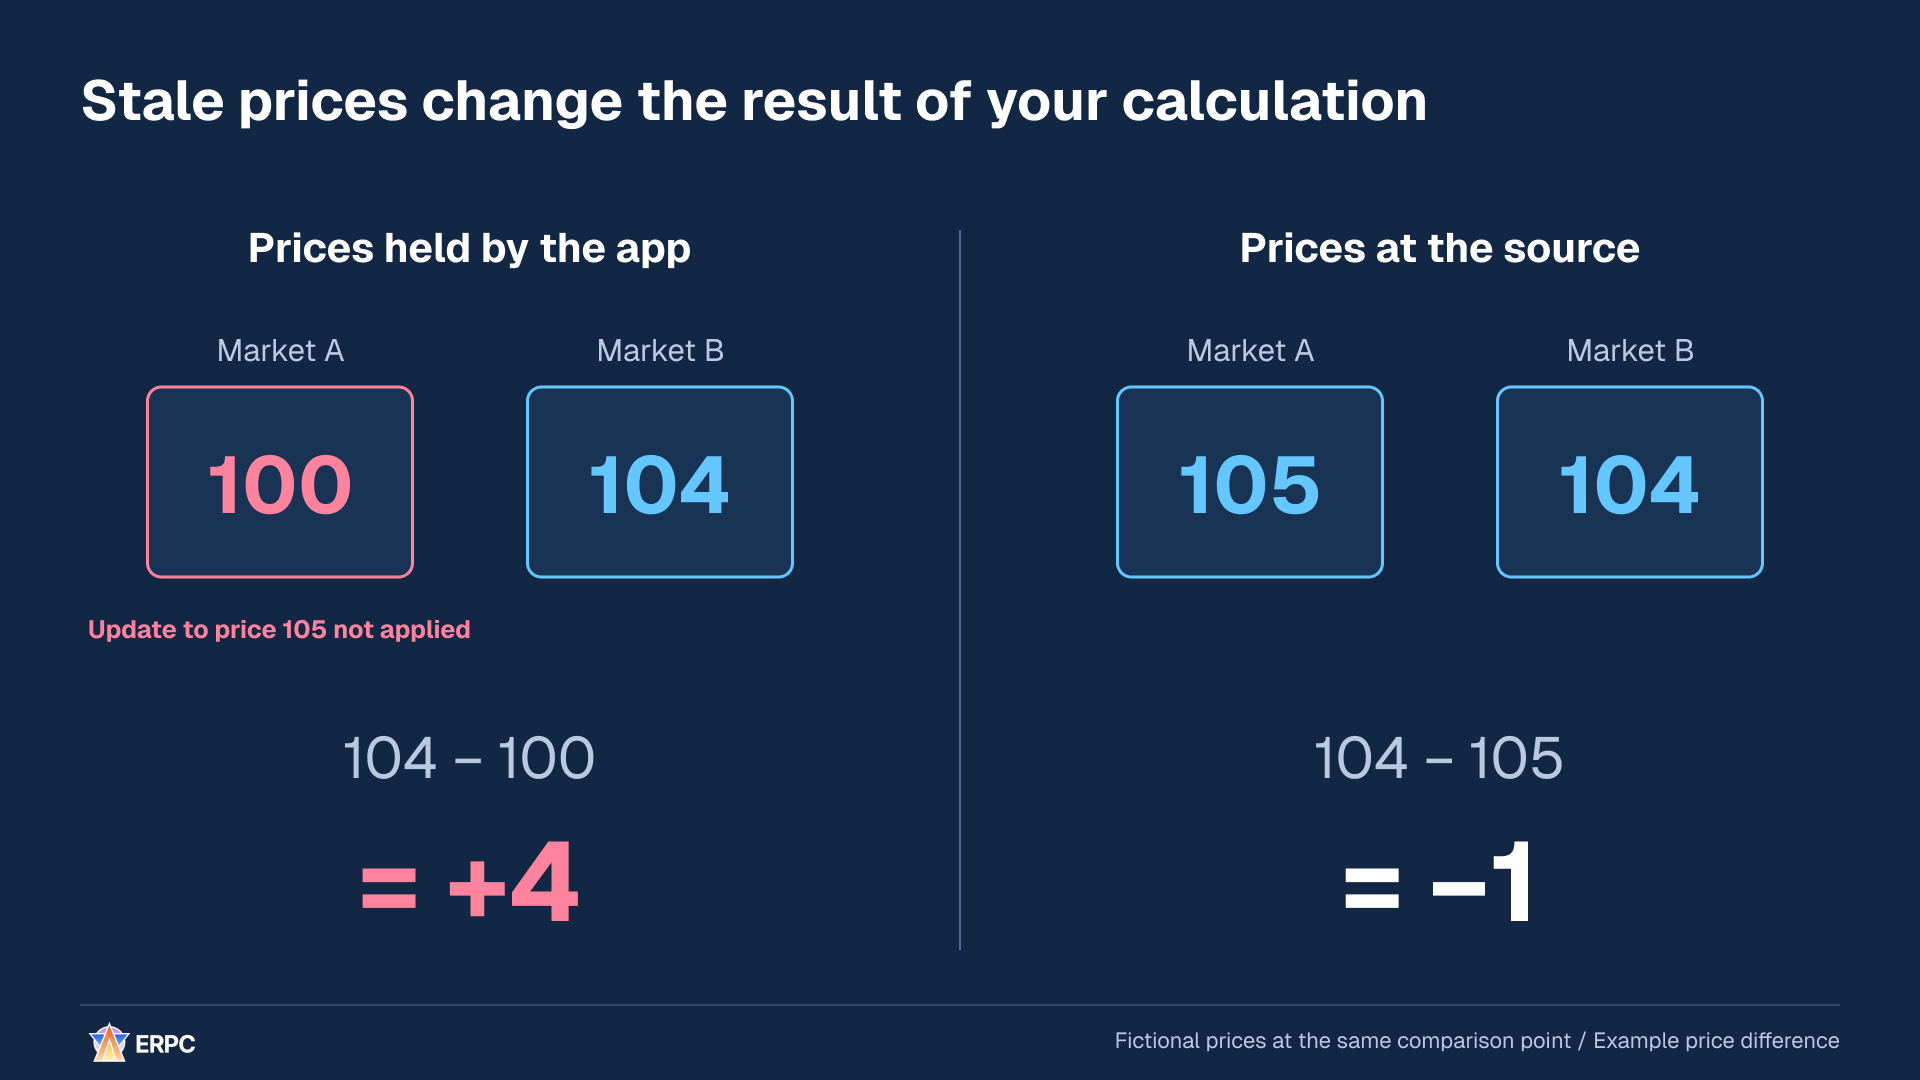
Dezelfde berekening verandert naargelang ze A's oude waarde 100 of de bijgewerkte waarde 105 gebruikt.
Dit model toont alleen een prijsverschil. Kosten, uitvoeringsvoorwaarden en andere factoren zijn niet meegenomen en het stelt geen handelswinst voor. Het laat zien dat het herstellen van de verbinding niet noodzakelijk alle updates herstelt die voor een beslissing nodig zijn.
Pauzeer in dit voorbeeld nieuwe handelsbeslissingen die de prijzen van A en B gebruiken en vervang A's oude waarde 100 door de herstelde waarde 105. Controleer daarna of de voor de beslissing noodzakelijke updates op A en B zijn toegepast en of aan de vereiste volgorde- en actualiteitsvoorwaarden is voldaan. Hervat zodra de noodzakelijke controles zijn afgerond en blijf gepauzeerd als dat niet kan.
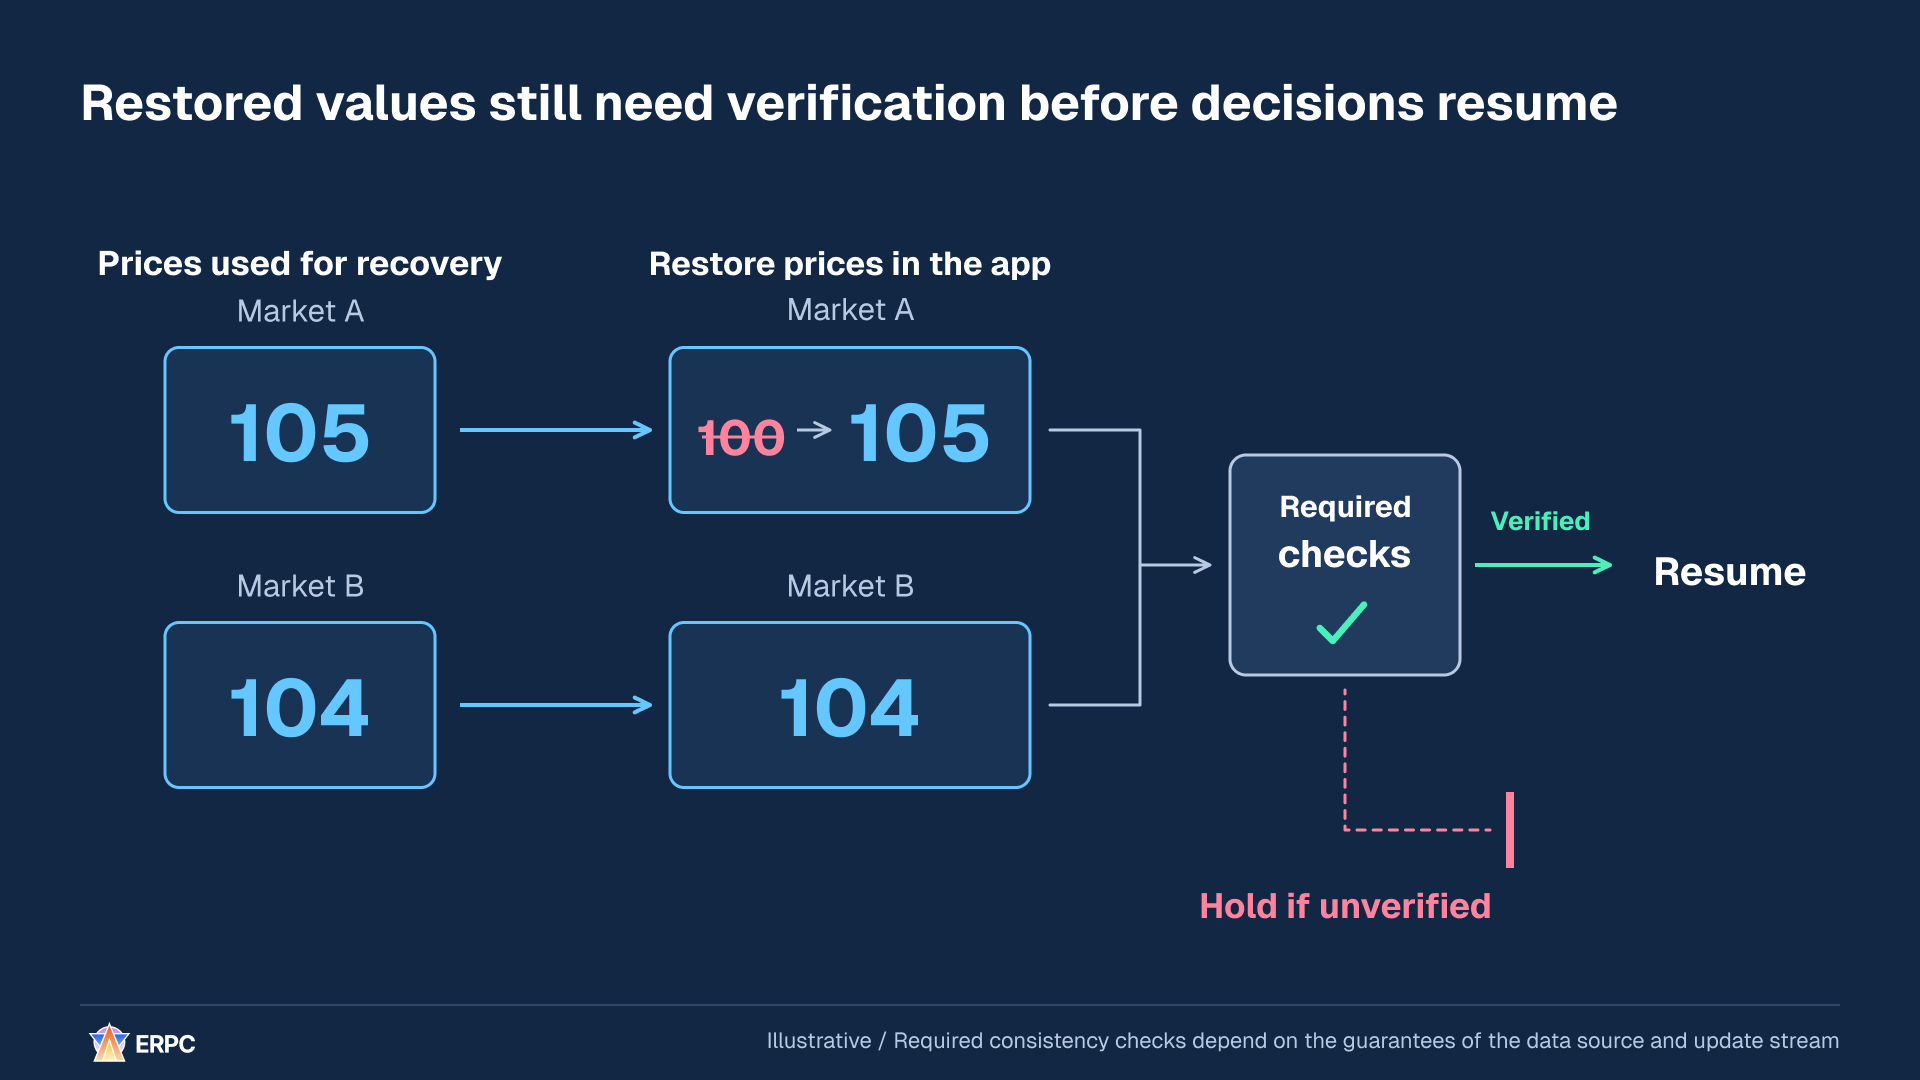
Scheid het bijwerken van de waarden van het controleren of die waarden voor beslissingen mogen worden gebruikt.
Een veelgebruikt herstelmechanisme is een snapshot: een vastlegging van de toestand op een bepaald moment. Wanneer je die aansluit op een doorlopende updatestroom, bepaal dan welke updates al in de snapshot zitten en welke latere updates moeten worden toegepast. Zo voorkom je dat een reeds opgenomen verschil twee keer wordt toegepast of dat een update op de grens ontbreekt. De concrete methode moet passen bij de garanties van de gekozen API voor de start van een abonnement, identificatie, opnieuw ophalen en opnieuw afspelen.
Yellowstone-berichten bevatten velden zoals slot en write_version.[16] Hun aanwezigheid alleen garandeert geen reeks die over aanbieders heen bruikbaar is, of volledige detectie van ontbrekende updates. Zet een verschil in slots niet rechtstreeks om in een aantal ontbrekende updates of seconden vertraging. Controleer of de toestand opnieuw is aangesloten volgens de garanties van de gekozen aanbieder.
Houd ook rekening met berekeningen die vóór het herstel begonnen. Een bewerking die met oude toestand startte en na het herstel eindigt, kan de nieuwe toestand met haar resultaat overschrijven. Een aanpak is om de toestand bij herstel een nieuw generatienummer te geven en resultaten uit een oudere generatie te weigeren. Gebruik je processed-toestand, neem dan ook rollbacks (waarbij die toestand niet langer wordt overgenomen) op als reden om de toestand opnieuw te beoordelen.[6]
Kopieer deze instructies om na opnieuw verbinden eerst een geldige toestand te herstellen voordat beslissingen worden hervat.
text
Voorkom dat deze applicatie handelsbeslissingen op basis van verouderde toestand hervat alleen omdat de verbinding terug is. Implementeer herstel van de vereiste toestand voordat beslissingen worden hervat.

Lees de README, ontwikkelinstructies, afhankelijkheden en code voor abonneren, initieel ophalen, toepassen van updates, opnieuw verbinden en beslissen. Gebruik de bestaande taal, runtime en SDK. Controleer de aanbieder, commitment, betekenis van updates en werkelijke garanties voor volgorde, identificatie, opnieuw ophalen en opnieuw afspelen.

1. Onderscheid verbindingsstatus, geldigheid van data en toestemming om beslissingen te hervatten. Als ontbrekende noodzakelijke updates of onvoldoende actualiteit zijn vastgesteld, pauzeer dan nieuwe handelsbeslissingen die van die toestand afhangen, terwijl noodzakelijke ontvangst, updates en herstel doorgaan.
2. Stel bij gebruik van een snapshot aan de hand van de garanties van de aanbieder vast welke updates die bevat en waar de grens met de volgende stroom ligt. Voorkom dubbel toepassen van verschillen, hiaten op de grens en een onjuiste toepassingsvolgorde. Vul ontbrekende garanties niet met aannames in. Beschouw slot of write_version niet als een onvoorwaardelijk bruikbare reeks voor het detecteren van ontbrekende updates.
3. Hervat niet alleen omdat waarden zijn opgehaald. Implementeer controles voor de updates, volgorde, actualiteit en consistentie die de betrokken beslissingen vereisen en houd die beslissingen gepauzeerd zolang de controles niet kunnen worden afgerond. Gebruik generaties of een gelijkwaardig mechanisme om te voorkomen dat oude berekeningen of ordervoorstellen worden toegepast of verzonden wanneer werk dat vóór het herstel begon later klaar is. Neem bij hervatting nieuwe beslissingen op basis van gevalideerde toestand. Handel bij gebruik van processed-toestand ongeldigverklaring en herstel na een rollback af.
4. Reproduceer met invoer zonder vertrouwelijke informatie gemiste updates tijdens een verbindingsonderbreking, duplicaten, updates in andere volgorde, verouderde data, herhaald opnieuw verbinden en voltooiing van werk uit een oude generatie. Controleer dat beslissingen vanaf verbindingsherstel tot afgeronde validatie gepauzeerd blijven en dat gevalideerde toestand overeenkomt met het verwachte resultaat.
5. Registreer hersteltijd, het aantal door ongeldige toestand onderdrukte beslissingspogingen en de duur van de pauze, opnieuw toegepaste of uitgesloten updates, de normale tijd van ontvangst tot beslissing, CPU en geheugen. Laat gepauzeerde perioden of ontbrekende updates niet stilzwijgend weg uit metingen. Geef meetgrenzen aan en wat wel en niet kan worden gedetecteerd. Gebruik binnen één host een monotone klok voor verstreken tijd.

Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.

Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.
Voorkom dat deze applicatie handelsbeslissingen op basis van verouderde toestand hervat alleen omdat de verbinding terug is. Implementeer herstel van de vereiste toestand voordat beslissingen worden hervat.
Lees de README, ontwikkelinstructies, afhankelijkheden en code voor abonneren, initieel ophalen, toepassen van updates, opnieuw verbinden en beslissen. Gebruik de bestaande taal, runtime en SDK. Controleer de aanbieder, commitment, betekenis van updates en werkelijke garanties voor volgorde, identificatie, opnieuw ophalen en opnieuw afspelen.
1. Onderscheid verbindingsstatus, geldigheid van data en toestemming om beslissingen te hervatten. Als ontbrekende noodzakelijke updates of onvoldoende actualiteit zijn vastgesteld, pauzeer dan nieuwe handelsbeslissingen die van die toestand afhangen, terwijl noodzakelijke ontvangst, updates en herstel doorgaan.
2. Stel bij gebruik van een snapshot aan de hand van de garanties van de aanbieder vast welke updates die bevat en waar de grens met de volgende stroom ligt. Voorkom dubbel toepassen van verschillen, hiaten op de grens en een onjuiste toepassingsvolgorde. Vul ontbrekende garanties niet met aannames in. Beschouw slot of write_version niet als een onvoorwaardelijk bruikbare reeks voor het detecteren van ontbrekende updates.
3. Hervat niet alleen omdat waarden zijn opgehaald. Implementeer controles voor de updates, volgorde, actualiteit en consistentie die de betrokken beslissingen vereisen en houd die beslissingen gepauzeerd zolang de controles niet kunnen worden afgerond. Gebruik generaties of een gelijkwaardig mechanisme om te voorkomen dat oude berekeningen of ordervoorstellen worden toegepast of verzonden wanneer werk dat vóór het herstel begon later klaar is. Neem bij hervatting nieuwe beslissingen op basis van gevalideerde toestand. Handel bij gebruik van processed-toestand ongeldigverklaring en herstel na een rollback af.
4. Reproduceer met invoer zonder vertrouwelijke informatie gemiste updates tijdens een verbindingsonderbreking, duplicaten, updates in andere volgorde, verouderde data, herhaald opnieuw verbinden en voltooiing van werk uit een oude generatie. Controleer dat beslissingen vanaf verbindingsherstel tot afgeronde validatie gepauzeerd blijven en dat gevalideerde toestand overeenkomt met het verwachte resultaat.
5. Registreer hersteltijd, het aantal door ongeldige toestand onderdrukte beslissingspogingen en de duur van de pauze, opnieuw toegepaste of uitgesloten updates, de normale tijd van ontvangst tot beslissing, CPU en geheugen. Laat gepauzeerde perioden of ontbrekende updates niet stilzwijgend weg uit metingen. Geef meetgrenzen aan en wat wel en niet kan worden gedetecteerd. Gebruik binnen één host een monotone klok voor verstreken tijd.
Behoud bestaande goedkeuringen, bevoegdheden en ontwikkelprocedures. Beschouw deze instructies op zichzelf niet als extra toestemming om productie te wijzigen, betaalde contracten aan te gaan of echte transacties uit te voeren. Toon geen privésleutels, toegangsgegevens of klantgegevens.
Rapporteer de wijzigingen, vergelijkingsvoorwaarden, metingen vóór en na, correctheidscontroles en resterende beperkingen. Markeer waarden die je niet kunt meten als niet gemeten.Vergelijk de sterke punten van talen op zes dimensies
Deze vijf ontwerpen implementeren betekent bepalen wie data bijwerkt, waar geheugen wordt gealloceerd, wat wordt gekopieerd en welke bewerkingen wachten. Snel rekenen, controle over plotselinge vertragingen en snel prototypes maken zijn verschillende sterke punten. Vergelijk talen op basis van het deel dat je wilt verbeteren.
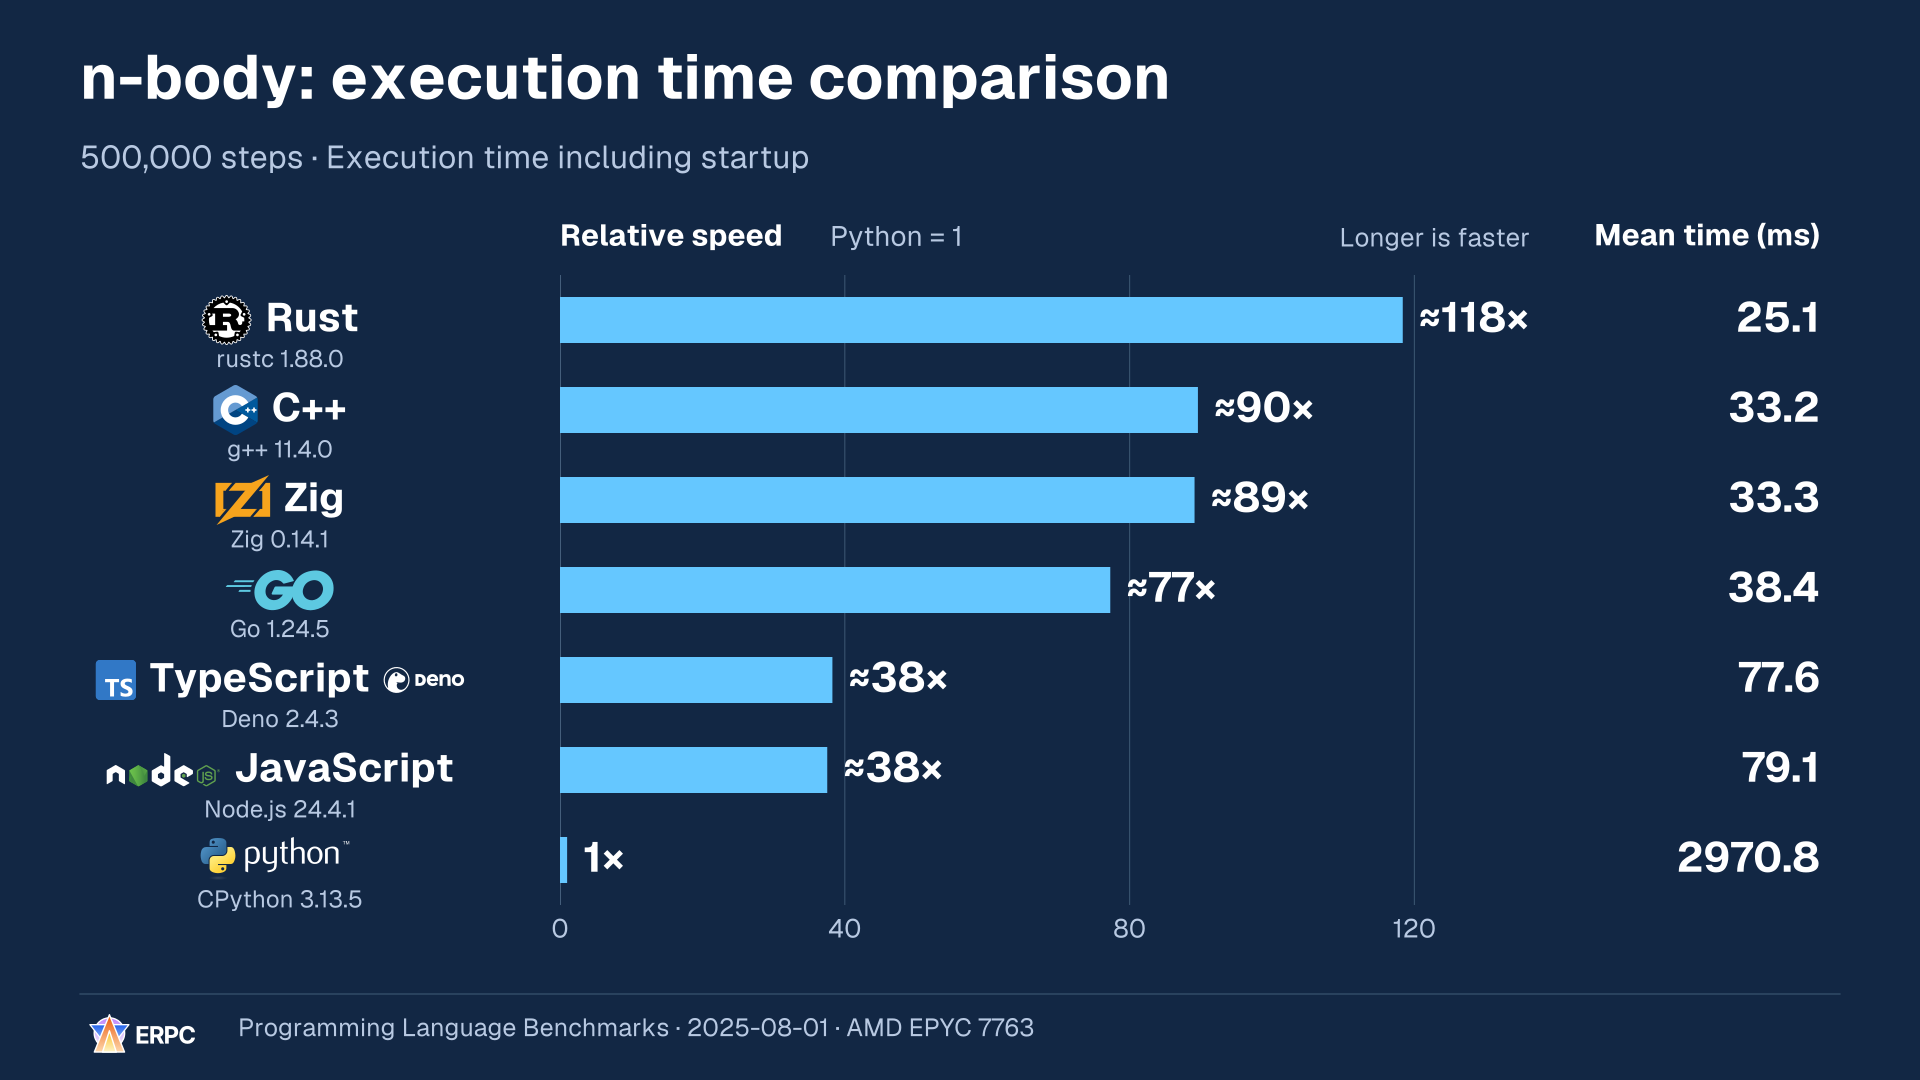
Uitvoeringstijden vergelijken in een gepubliceerde benchmark
Deze gepubliceerde metingen van 1 augustus 2025 voeren een berekening met vijf lichamen uit over 500.000 stappen. De gemiddelde uitvoeringstijd is de gemiddelde tijd van het starten van het programma tot de voltooiing. Opstarten en codeoptimalisatie tijdens het uitvoeren tellen mee; de voorafgaande build niet. 1.000 ms is één seconde.[27][29]
| Taal / runtime | Gemiddelde uitvoeringstijd | Relatieve snelheid (Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1 ms | ≈118 |
| C++ / g++ 11.4.0 | 33.2 ms | ≈90 |
| Zig / Zig 0.14.1 | 33.3 ms | ≈89 |
| Go / Go 1.24.5 | 38.4 ms | ≈77 |
| TypeScript / Deno 2.4.3 | 77.6 ms | ≈38 |
| JavaScript / Node.js 24.4.1 | 79.1 ms | ≈38 |
| Python / CPython 3.13.5 | 2970.8 ms | 1 |
De relatieve snelheden zijn berekend uit de onafgeronde gemiddelde tijden, met Python = 1. Voor elke taal- en runtimefamilie kiezen we het laagste gepubliceerde gemiddelde onder stabiele implementaties waarvan de numerieke berekening één thread gebruikt, zonder expliciete SIMD-intrinsics, vectortypen of externe numerieke bibliotheken. Code en optimalisaties verschillen; Zig gebruikt ReleaseFast. TypeScript draait als een uitvoerbaar bestand met Deno/V8, terwijl JavaScript op Node.js draait.[28]
Lees waarden die dicht bij elkaar liggen als vergelijkbare resultaten en maak van deze ene taak geen algemene rangschikking van talen. Ze meet niet rechtstreeks de verwerkingstijd van een bot die na het opstarten blijft draaien, of de vertraging totdat een order zijn bestemming bereikt.
De opgegeven omgeving is Linux op een AMD EPYC 7763 met vier beschikbare cores. De gepubliceerde meetcode is ingesteld op drie herhalingen per conditie en start telkens een nieuw proces. De exacte commit van de historische uitvoering en de ruwe afzonderlijke metingen konden niet worden geverifieerd; daarom presenteren we de gepubliceerde gemiddelden.[28][29]
Ontwerpsterkten vergelijken langs zes dimensies
De volgende diagrammen zijn redactionele keuzehulpen met drie niveaus voor een off-chain Solana-client. De dimensie Rekensnelheid bekijkt mogelijkheden om data-intensieve leesbewerkingen en berekeningen te versnellen die rechtstreeks in de vergeleken taal en implementatie zijn geschreven. Ze rangschikt geen complete applicaties waarvan de tijd vooral opgaat aan wachten op het netwerk, of berekeningen die aan versnelde externe bibliotheken worden uitbesteed.
Rust, Go, C++ en Zig zijn sterke kandidaten voor geoptimaliseerde native uitvoering. Dit betekent niet dat ze even snel zijn; een preciezere volgorde vereist metingen van de werkelijke werklast. Ook V8 zet vaak uitgevoerde functies om in machinecode. JavaScript traag noemen alleen omdat het geïnterpreteerd wordt, zou onjuist zijn.[20][21]
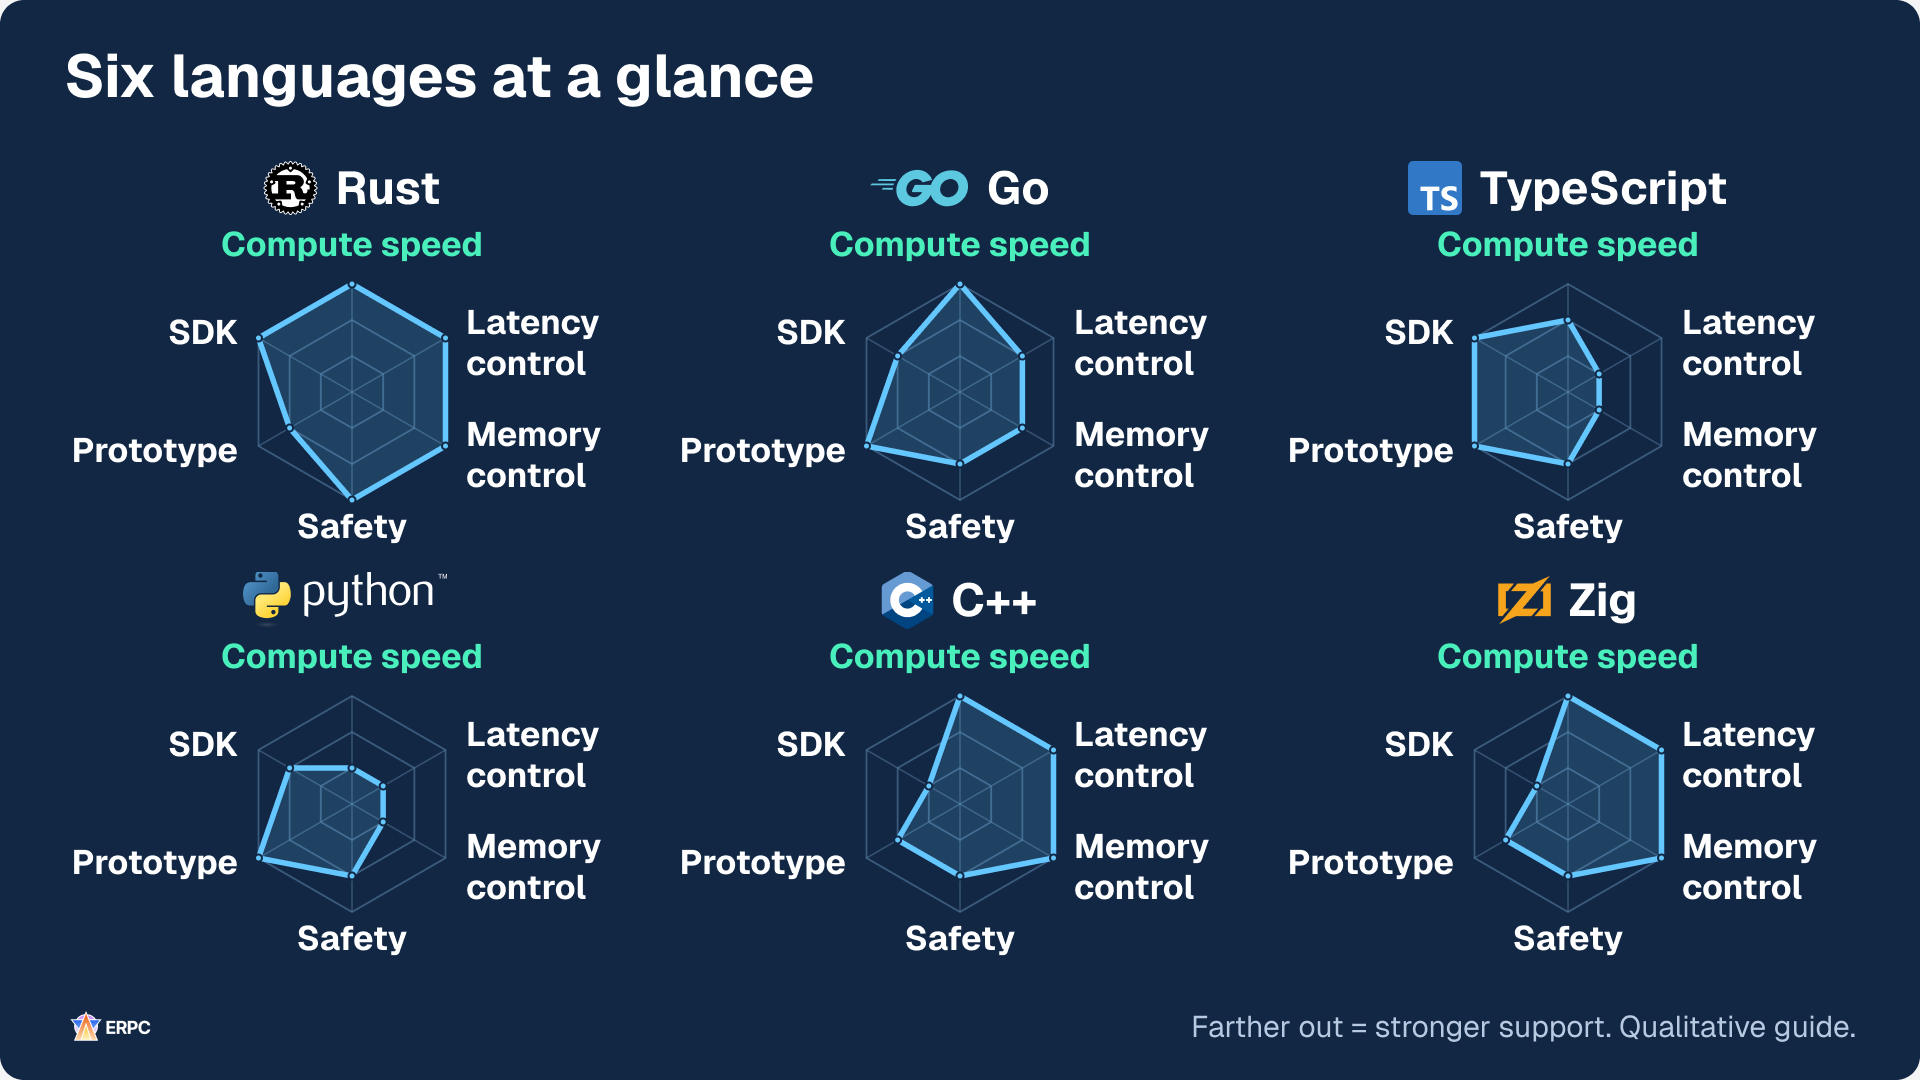
Drie dimensies, Rekensnelheid, Latentiecontrole en Geheugencontrole, beschrijven berekening en controle. Veiligheidsondersteuning, Prototypegemak en Solana SDK beschrijven ondersteuning bij de ontwikkeling. Niet alle zes assen staan voor verwerkingssnelheid.
Elke zeshoek gebruikt dezelfde assen en schaal. Verder naar buiten betekent een sterker kwalitatief punt op die dimensie. Dit zijn geen gemeten snelheden of verhoudingen: niveau 3 betekent niet drie keer niveau 1. Vergelijk de afzonderlijke dimensies die je wilt verbeteren, in plaats van het oppervlak van de veelhoek als totaalscore te behandelen.
| Dimensie | Wat wordt vergeleken |
|---|---|
| Rekensnelheid | Mogelijkheden om eigen data-intensieve leesbewerkingen en berekeningen binnen de vergeleken implementatie te versnellen |
| Latentiecontrole | Hoe direct werk zoals geheugenallocatie, terugwinning van geheugen en codeoptimalisatie tijdens uitvoering buiten belangrijke verwerking kan worden gehouden om plotselinge vertragingen te beperken |
| Geheugencontrole | Hoe direct je data-indeling, eigendom en levensduur, allocatie, hergebruik en terugwinning kunt ontwerpen |
| Veiligheidsondersteuning | Hulp van taalfuncties, runtimes en standaardgereedschap bij het voorkomen van fouten rond geheugenlevensduur en gedeeld geheugen |
| Prototypegemak | Gemak waarmee je een kleine applicatie kunt starten en wijzigingen kunt proberen; een redactioneel oordeel dat afhangt van ervaring en bestaande code |
| Solana SDK | Hoe gemakkelijk de officiële Solana-documentatie naar client-SDK's en voorbeelden voor het beoogde gebruik leidt |
De controledimensies beoordelen directe ontwerpmogelijkheden, veiligheid beoordeelt beschikbare ondersteuning en de SDK-dimensie de route vanuit officiële documentatie. Hetzelfde niveau kan verschillende mechanismen en garanties vertegenwoordigen.[8][13][20][21][26]
Het overzicht vergelijkt zes talen in drie kolommen en twee rijen: Rust, Go, TypeScript, Python, C++ en Zig. Vergelijk de dimensies die voor jou belangrijk zijn. Controleer daarna met de afzonderlijke diagrammen en toelichtingen hieronder de aannames over de runtime en geschikte toepassingen.
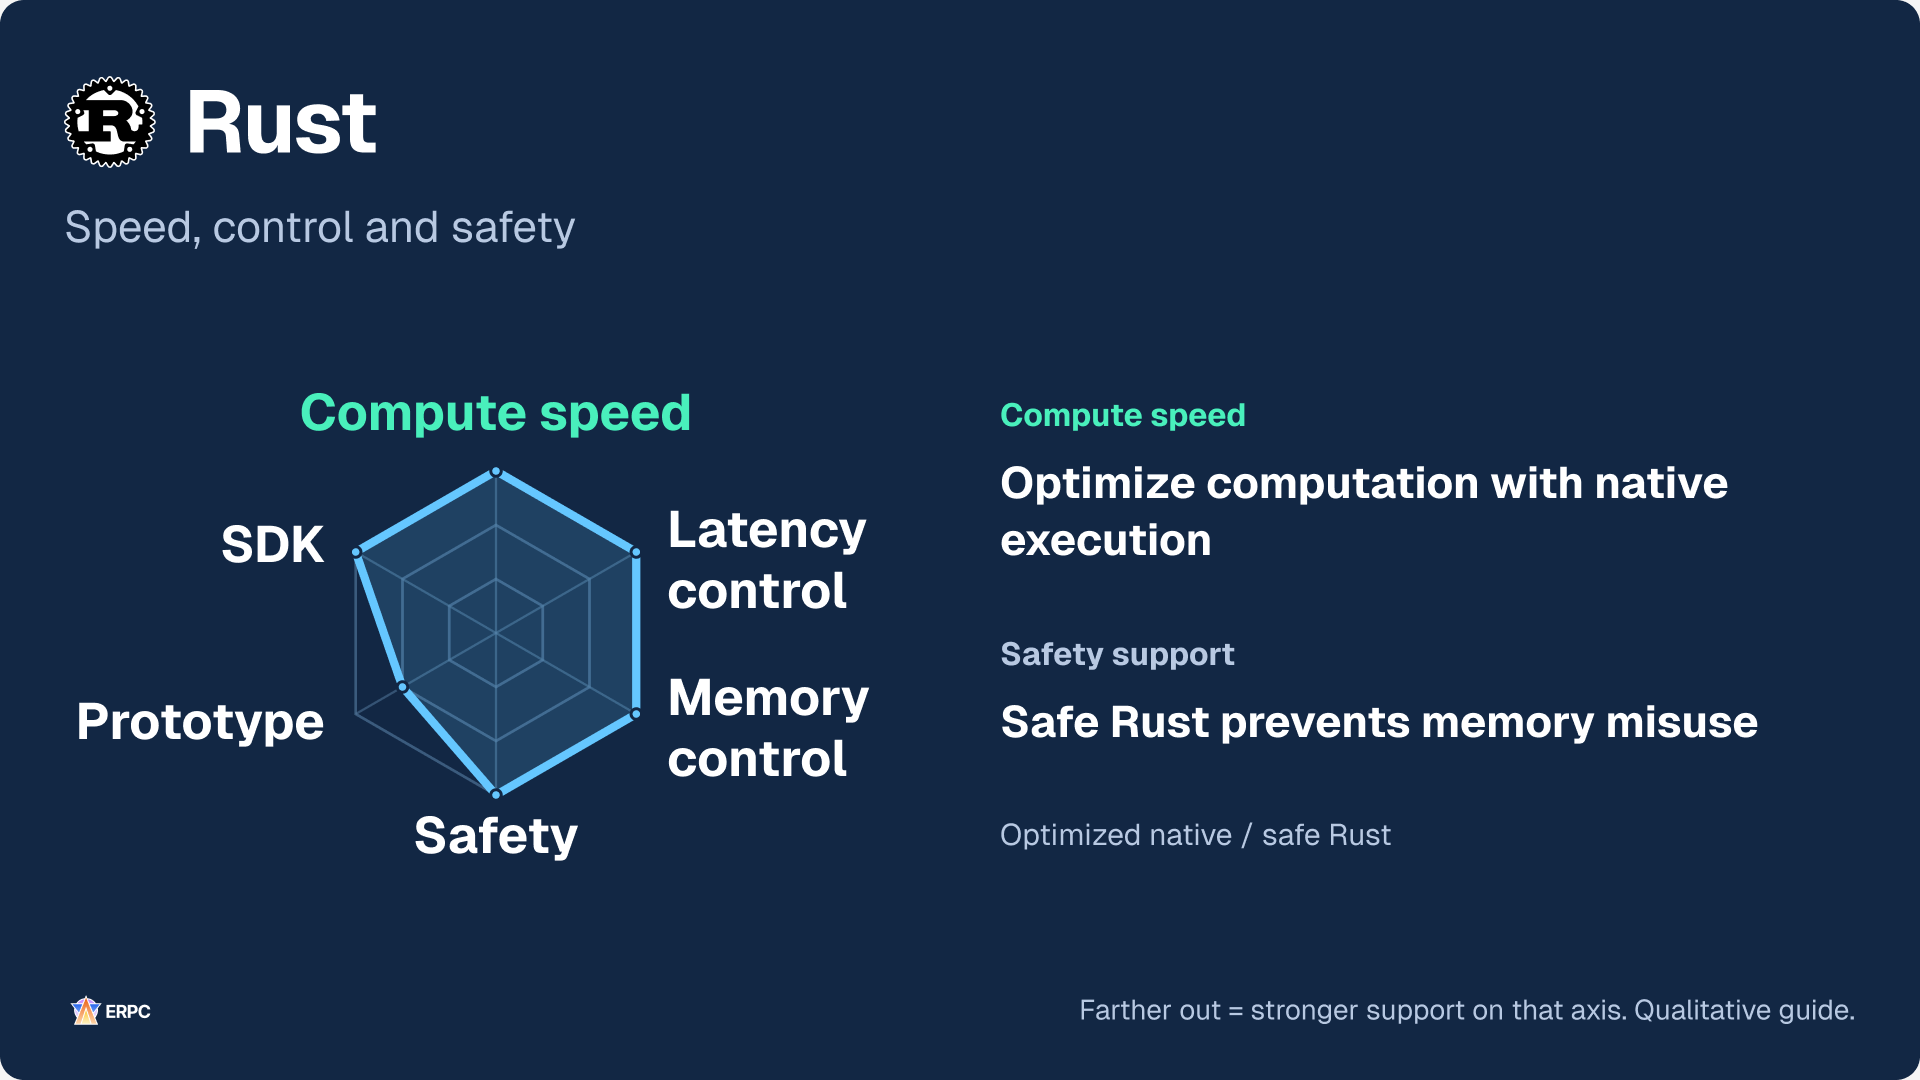
Rust combineert controle over indeling, allocatie en hergebruik op belangrijke paden met controles op eigendom en lenen. Het gebruikelijke geheugenbeheer vereist geen tracing-GC.[8] De garanties van safe Rust tegen dataraces garanderen niet dat algemene racecondities, deadlocks of onjuiste beslissingslogica ontbreken. Unsafe-code en interfaces met andere talen vereisen afzonderlijke verificatie.[22] Kopiëren, alloceren, vrijgeven, locks en wachten op het besturingssysteem blijven bestaan, dus test de werkelijke invoer en belasting.
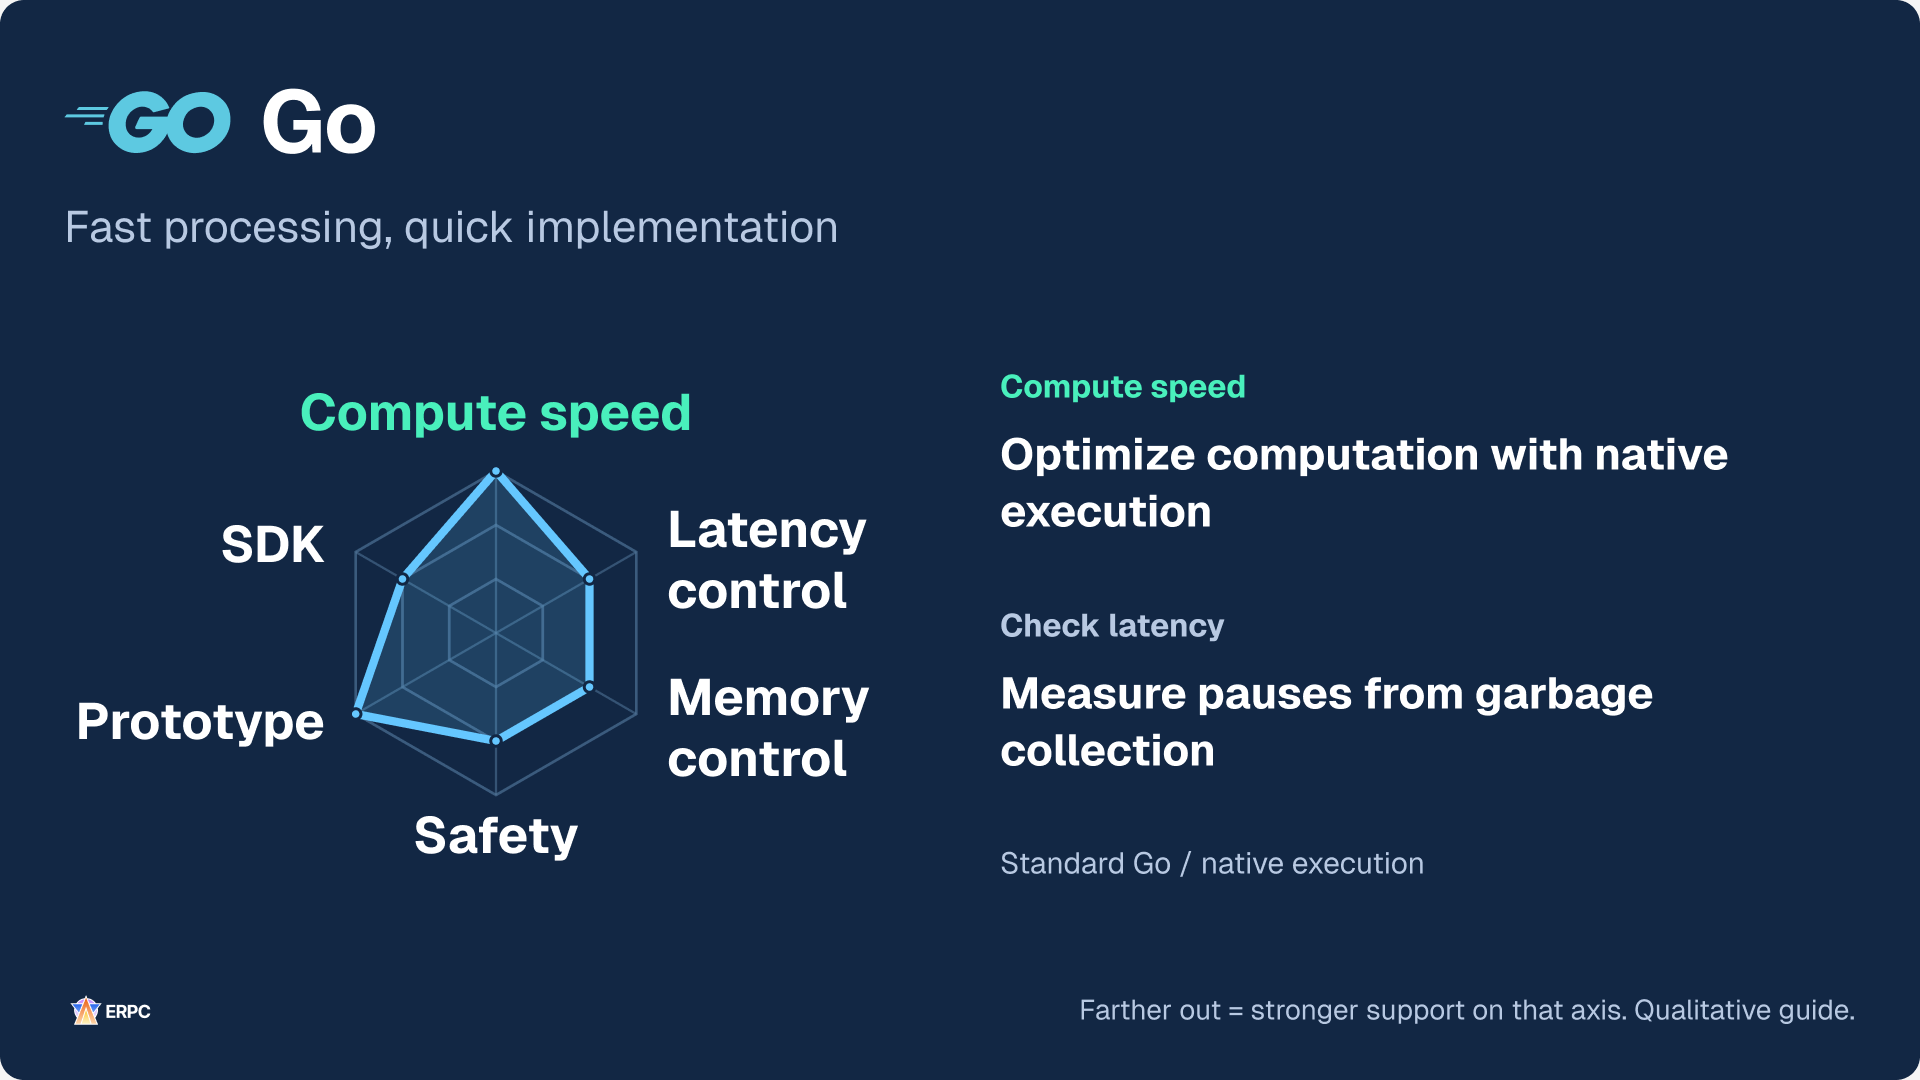
Ook Go is een kandidaat voor native gecompileerde uitvoering. Het helpt gelijktijdige diensten en verwerking op te bouwen, terwijl de runtime geheugenbeheer en andere bewerkingen ondersteunt.[20] Het meeste GC-werk verloopt gelijktijdig, maar meet de allocaties en de CPU-, geheugen- en latentiekosten van opruiming. De mogelijkheden voor CPU-verwerking staan los van directe controle over wanneer geheugen wordt teruggewonnen.[13]
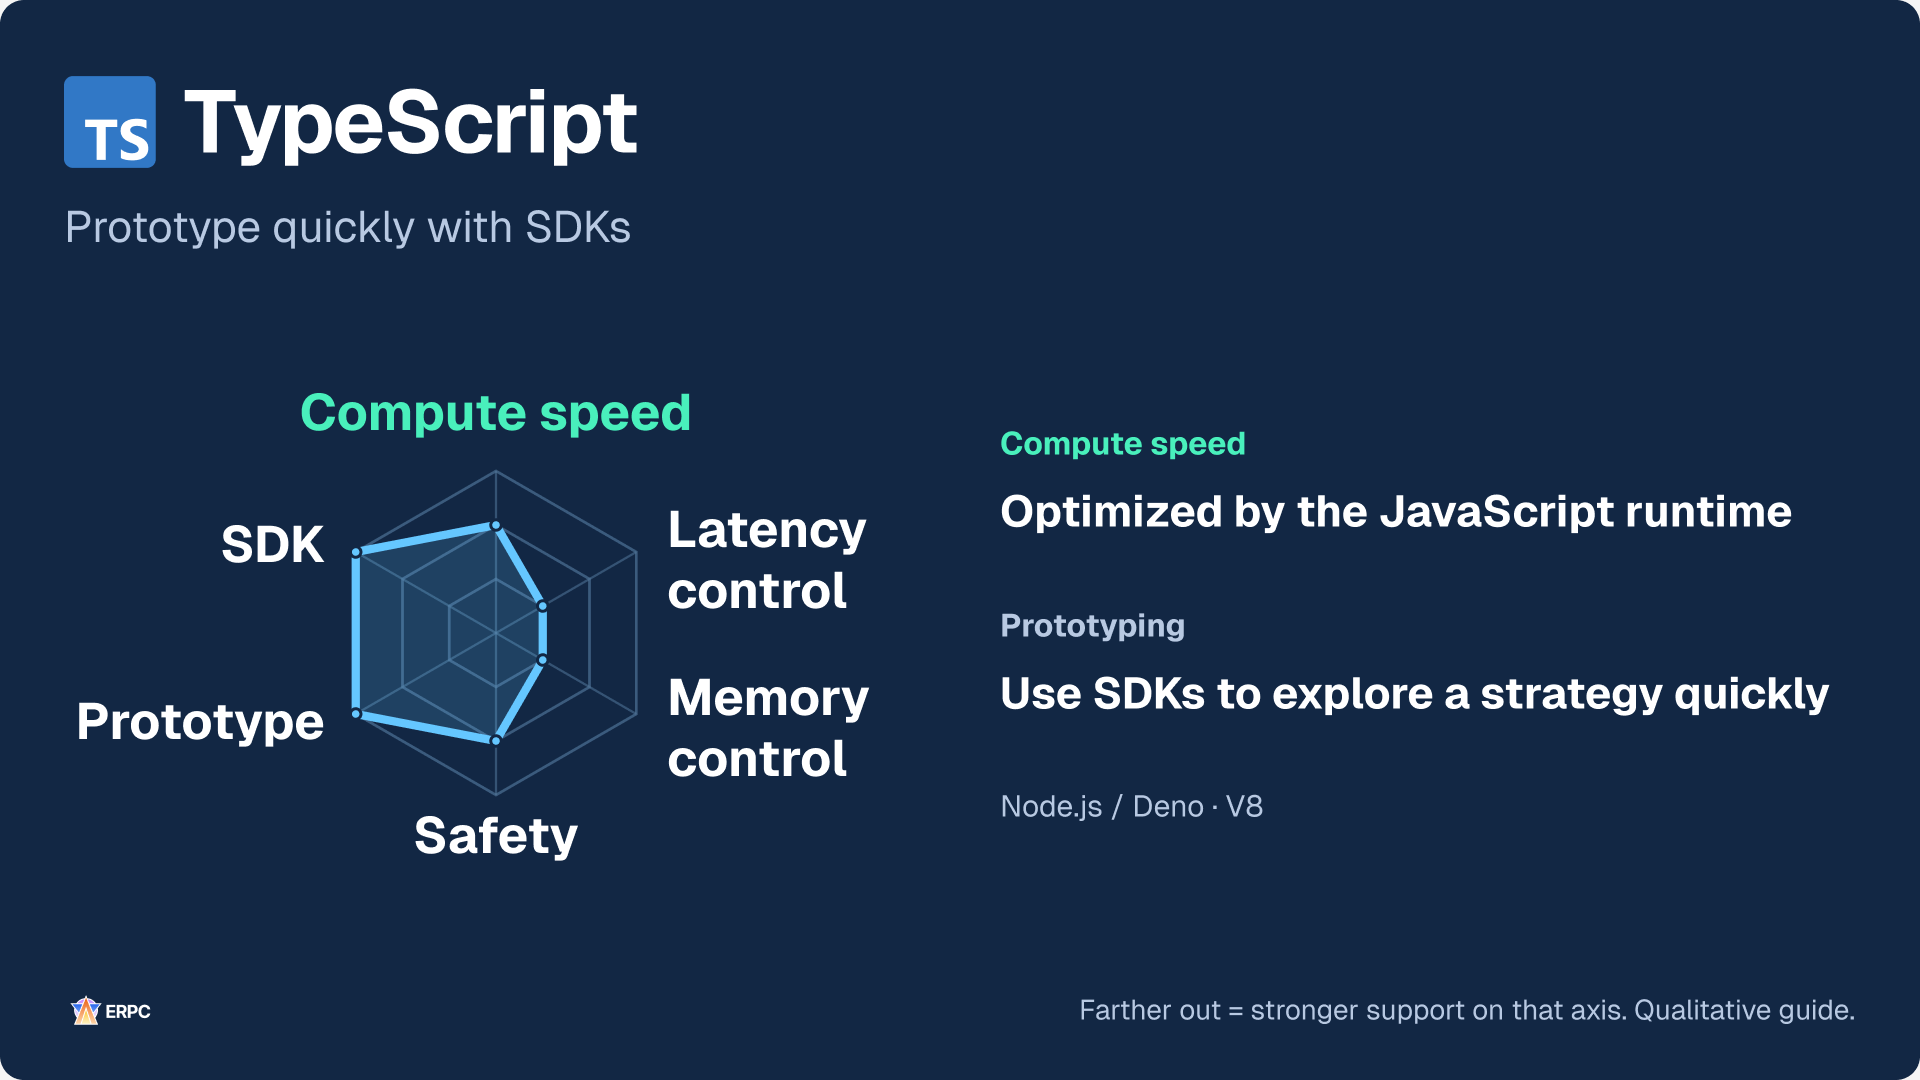
TypeScript is een taal; Node.js en Deno zijn runtimes. Dit diagram betreft JavaScript dat V8 uitvoert. Typeannotaties verdwijnen uit de uitgevoerde code, dus typen toevoegen versnelt CPU-werk op zichzelf niet. Externe data moet nog steeds tijdens uitvoering worden gevalideerd.[9][10][21] Deze opties kunnen API-integratie, configuratie, monitoring, webinterfaces en stroomverwerking verzorgen die aan de prestatie-eisen voldoet.
Node.js worker_threads en Deno Web Workers kunnen CPU-werk naar een andere uitvoeringscontext verplaatsen. De Node.js-documentatie beveelt een workerpool aan boven het aanmaken van een worker per taak. Tel naast de berekening op de bestemming ook conversie, kopiëren en wachten op het aanbieden van werk mee.[11][12]
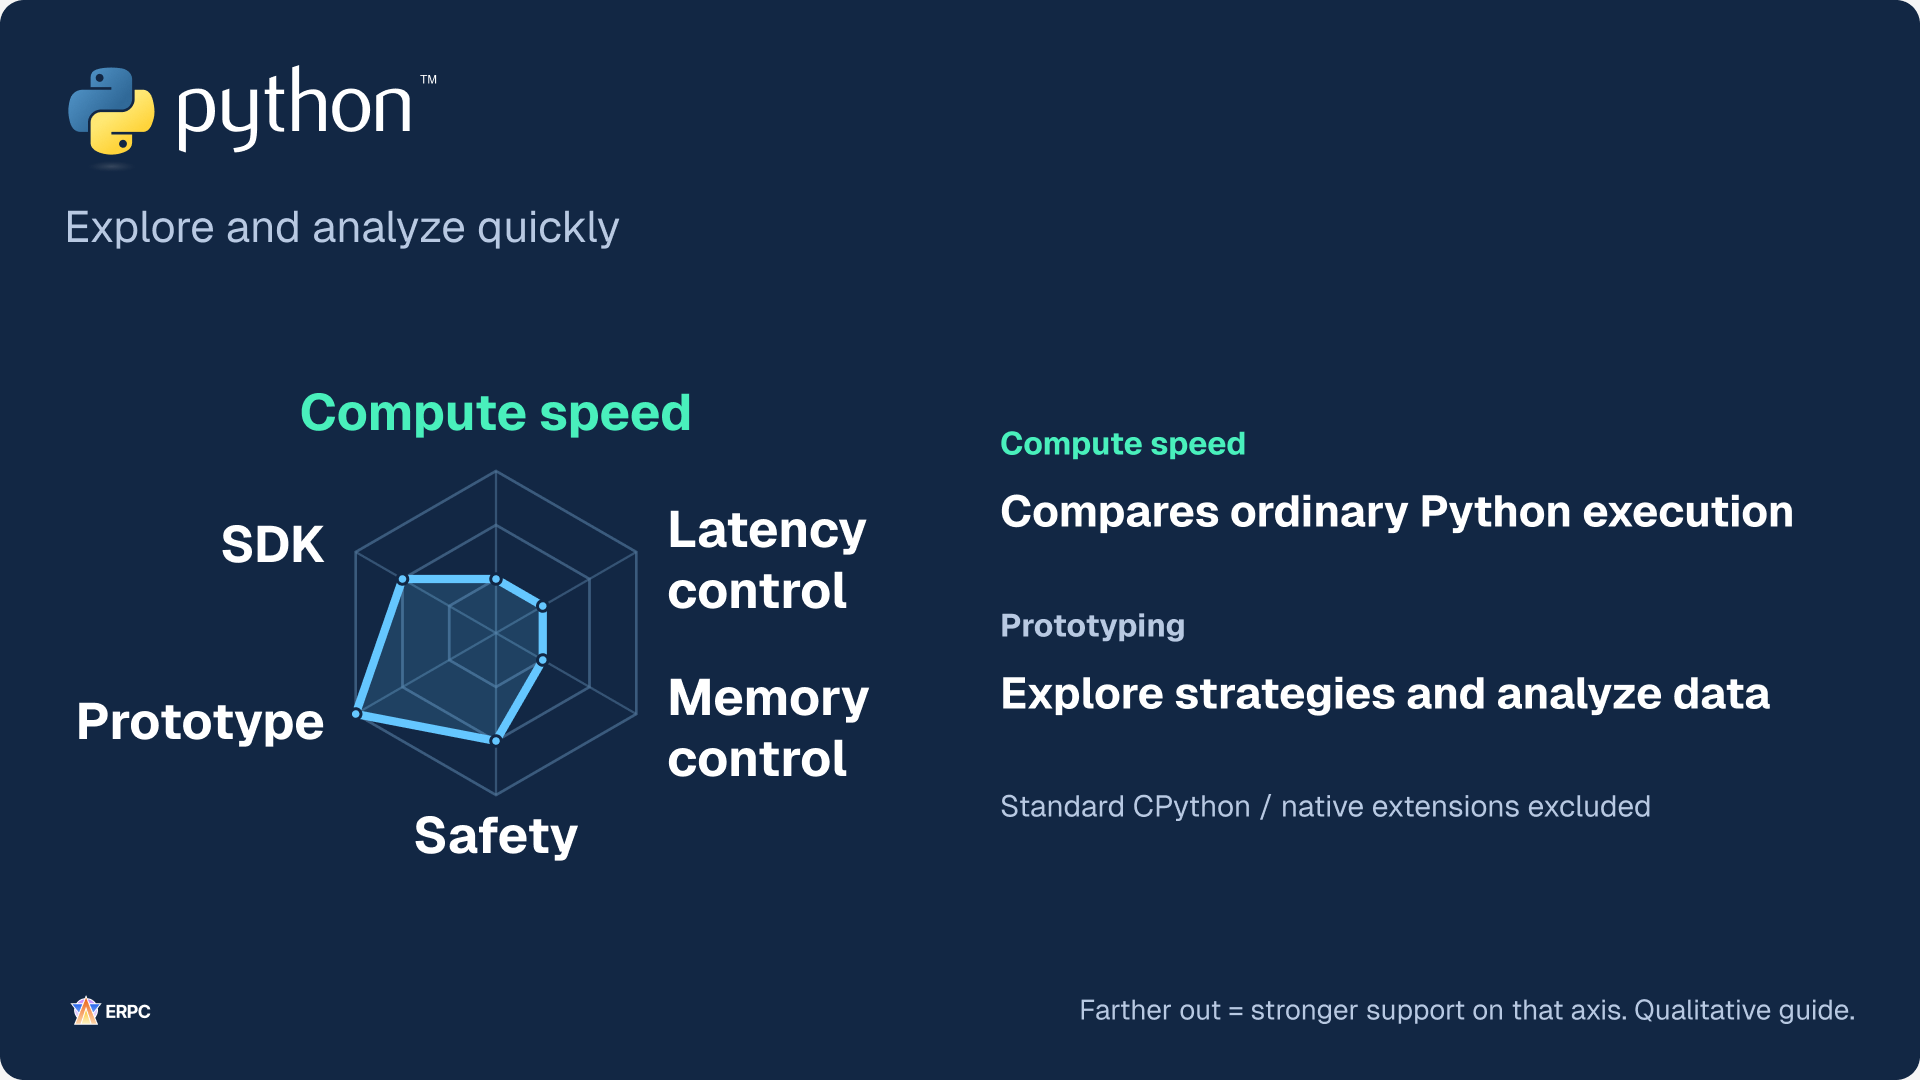
Python is een kandidaat voor onderzoek, analyse, validatie en werk met bestaande bibliotheken. De CPU-beoordeling betreft hier lussen die in Python zijn geschreven en binnen gewoon CPython worden uitgevoerd. Berekeningen die aan gecompileerde code worden overgedragen, zoals NumPy-bewerkingen, zijn een ander geval.[23] Controleer de werkelijke configuratie, waaronder free-threaded builds, in plaats van alleen op de taalnaam af te gaan.[14] Meet bij het verplaatsen van een deel naar Rust of een andere implementatie conversie en kopiëren op de grens en controleer of de gehele applicatie profiteert.
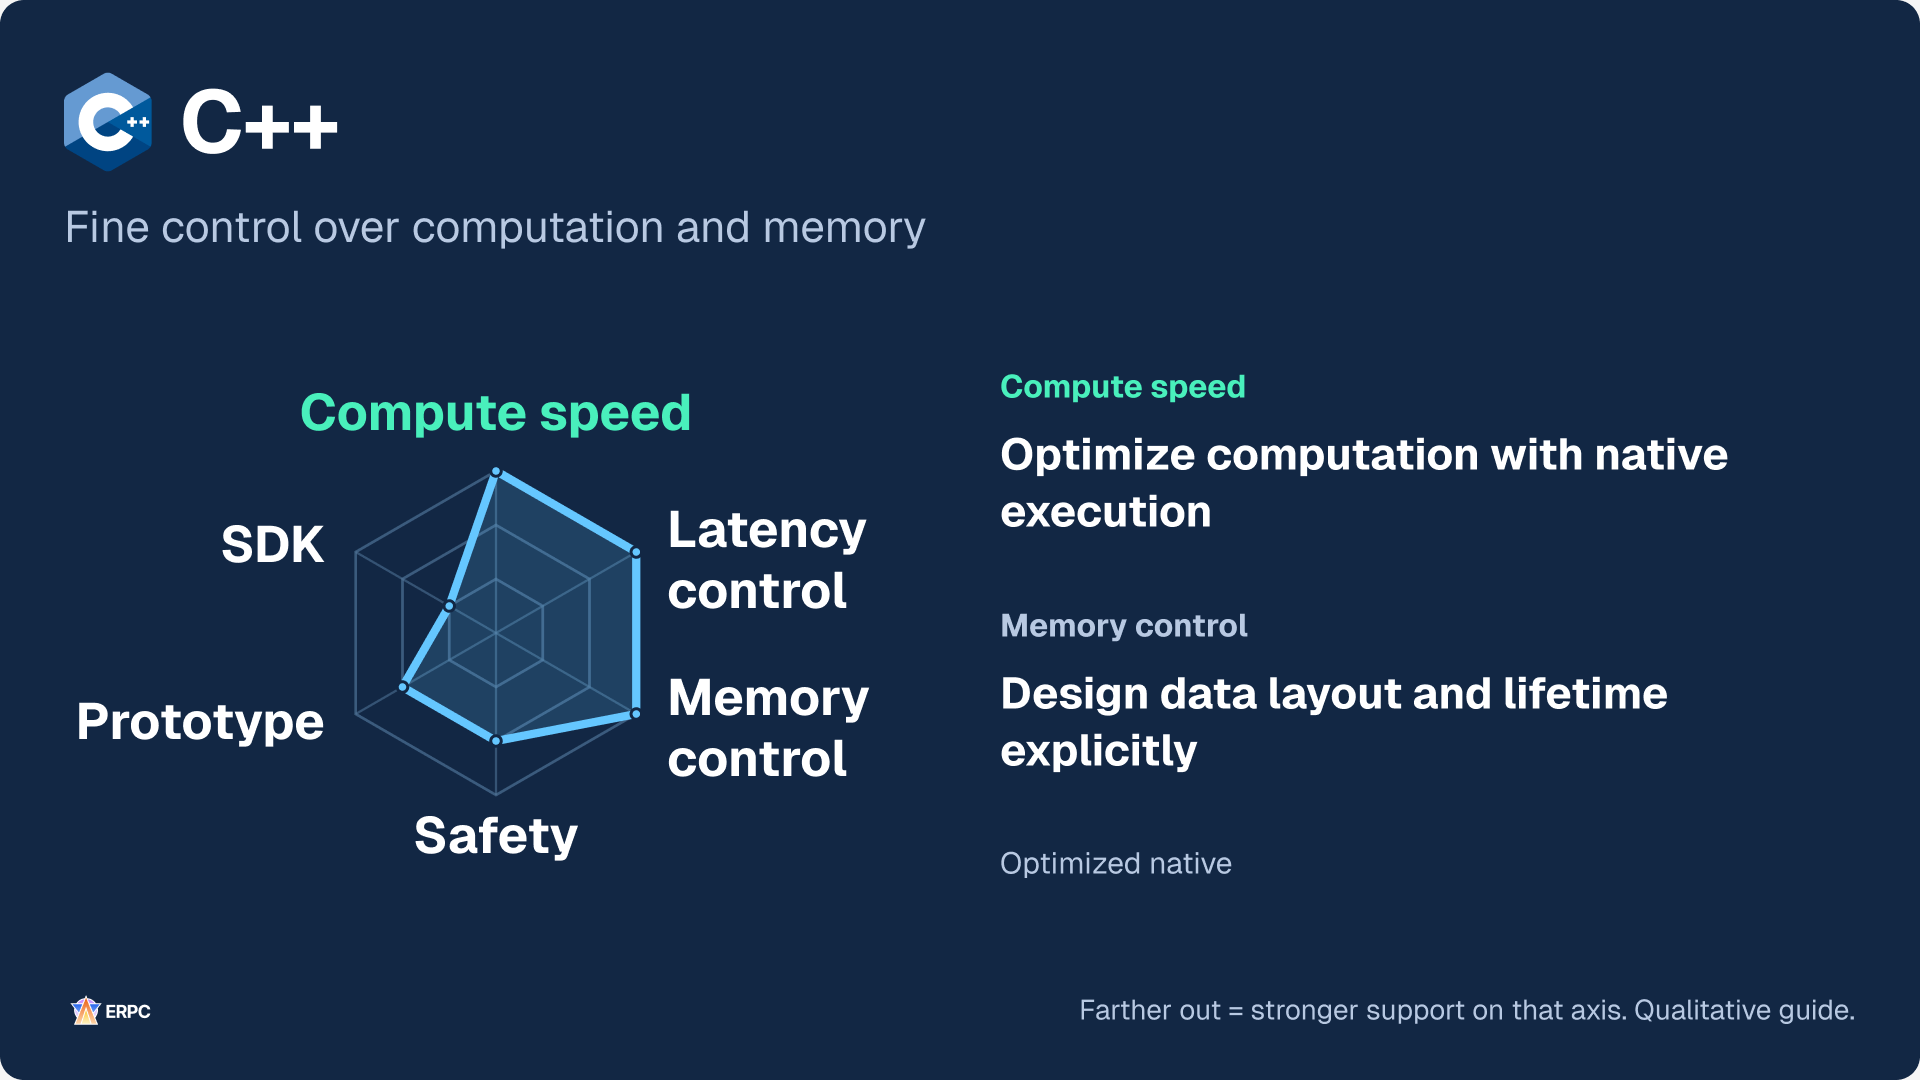
C++ combineert controle op laag niveau met abstracties en bestaande bibliotheken. RAII en slimme pointers helpen de levensduur van resources te beheren, maar hun gebruik garandeert niet alle veiligheid rond geheugenlevensduur of gedeeld geheugen.[24] Het middenniveau voor veiligheid impliceert ook niet dezelfde garanties als beheerd geheugen bij opties zoals Go.
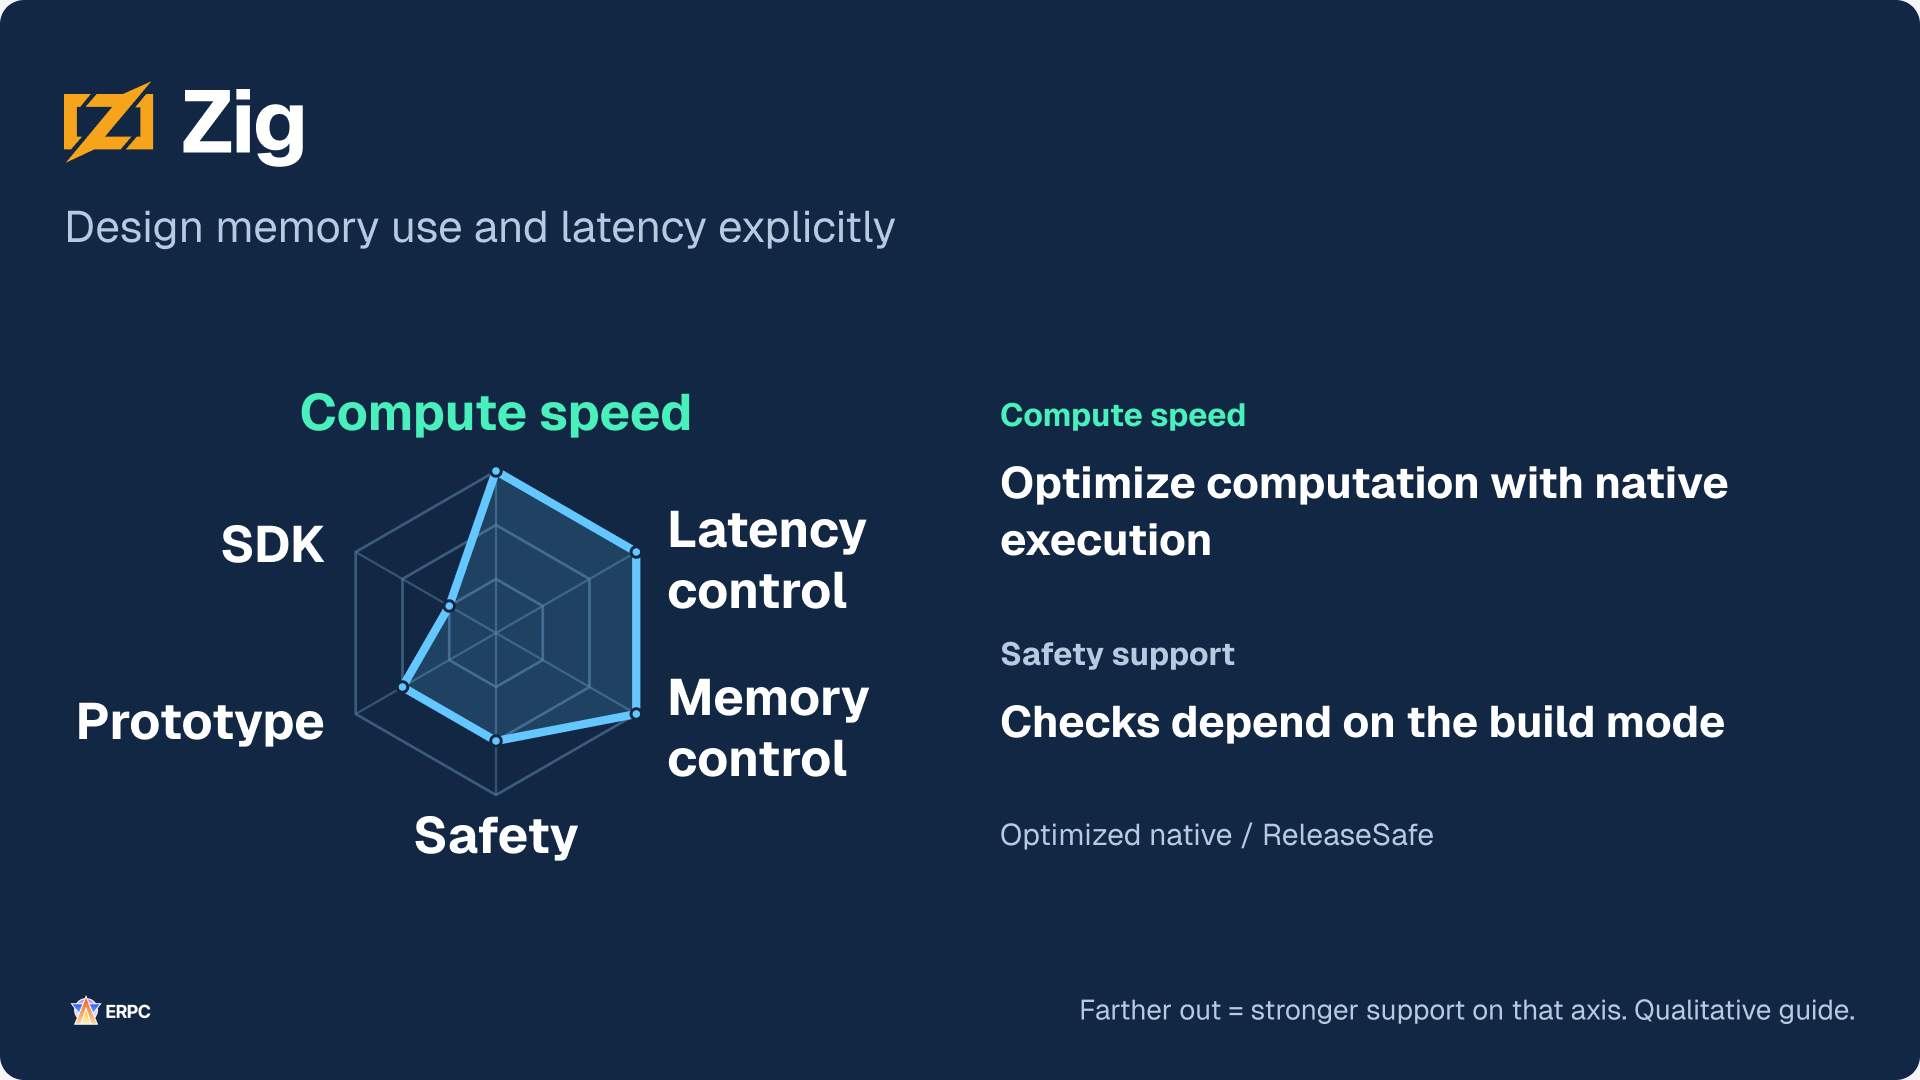
Zig ondersteunt expliciete structurering van allocatie en de keuze van allocators. Dit profiel gaat uit van de controles in ReleaseSafe. ReleaseFast en ReleaseSmall hebben andere standaardcontroles en ReleaseSafe detecteert niet elk geval van ongeldig gedrag.[25] Dezelfde veelhoekvorm als C++ hebben betekent niet dat de mechanismen identiek zijn.
De dimensie Solana SDK gebruikt de routes in officiële documentatie voor TypeScript en Rust en de daarin genoemde Go- en Python-clients. Ze rangschikt niet het algemene aantal of de kwaliteit van bibliotheken en beweert niet dat C++ en Zig geen bibliotheken hebben. Controleer voor de werkelijke SDK de benodigde API's, onderhoud en aansluiting bij wijzigingen en compatibiliteit met de gekozen runtime, waaronder Deno.[26]
Meet waar je applicatie tijd besteedt en kies vervolgens de sterke punten die dat deel nodig heeft. Verminder eerst wachten en herhaald werk in de huidige taal. Als fijnere controle nodig is, blijft het verplaatsen van het betreffende deel naar een andere taal een optie.
Vergelijk wijzigingen onder dezelfde voorwaarden
De instructies van elke sectie omvatten het implementeren en valideren van die verbetering. Als je meerdere verbeteringen toepast, houd dan elke wijziging gekoppeld aan haar meetresultaten. Wijzigingen samen toepassen maakt het moeilijker te onderscheiden welke wijziging welk resultaat beïnvloedde.
Vergelijk vóór en na de wijziging met dezelfde invoer, abonnementsinstellingen, belasting en uitvoereisen. Bekijk voor de tijd tussen ontvangst en afgeronde beslissing naast de mediaan p50 ook p95 en p99. De p99 is een grens waarbinnen 99% van de gemeten gebeurtenissen klaar is. Zo zie je naast de gebruikelijke verwerking ook de tragere kant van de verdeling.
De p99-waarden van afzonderlijke stappen optellen levert niet de p99 van het hele pad op. Meet voor elke gebeurtenis rechtstreeks de volledige duur van ontvangst tot afgeronde beslissing, samen met wachtrijtijden, CPU- en geheugengebruik, ontbrekende of weggegooide updates en overeenstemming tussen beslissingsresultaten.
Gebruik voor verstreken tijd binnen één host een monotone klok die niet achteruitgaat wanneer de wandkloktijd wordt gecorrigeerd. Als een SDK een callback pas na het decoderen aanroept, heeft er al verwerking plaatsgevonden voordat de callback begint. Vermeld precies waar elke meting begint en eindigt, zodat bezorglatentie en applicatielatentie afzonderlijk kunnen worden bekeken.
Controleer ook wat er na verzending gebeurt. Een geslaagd sendTransaction-antwoord garandeert geen verwerking of bevestiging door het cluster.[15] Door ontvangst, beslissing, acceptatie van de verzending en het waargenomen resultaat op de blockchain aan elkaar te koppelen, kun je de volgende verbeterplek kiezen.
Zet snelle bezorging om in tijdige beslissingen
Zowel snelle bezorging als een applicatie die de benodigde beslissingen op tijd afrondt, zijn belangrijk. ERPC blijft de bezorginfrastructuur verbeteren en informatie ontwikkelen die helpt de daarop draaiende software te verbeteren.
Valideer applicatiewijzigingen eerst in dezelfde omgeving. Vergelijk daarna waar nodig dezelfde code op verschillende locaties of met andere resources om hun effecten te onderscheiden. Bepaal bij ERPC's facturering per uur vooraf de hypothese, vergelijkingsvoorwaarden en gebruiksduur, en controleer de actuele prijzen en beschikbaarheid in het Dashboard.
Bronnen en gerelateerde links
- [1] Tokio / CPU-intensieve taken en blokkeren
- [2] Node.js / De event loop niet blokkeren
- [3] gRPC / Flow Control
- [4] Yellowstone gRPC / Berichten en abonnementsspecificaties
- [5] LMAX Disruptor / Ontwerp en gebruik
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / Ownership
- [9] TypeScript / Runtimegedrag en gewiste typen
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / Garbage Collector
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / Berichtdefinities
- [17] Rust / std::sync::Mutex
- [18] Tokio / Gedeelde toestand en mutex sharding
- [19] Solana / Transactiestructuur en handtekeningen
- [20] Go / Veelgestelde vragen
- [21] V8 / Algemeen overzicht
- [22] Rust / Dataraces en racecondities
- [23] NumPy / Wat is NumPy?
- [24] C++ / Kernrichtlijnen
- [25] Zig / Taalreferentie
- [26] Solana / Client-SDK’s
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- Logo’s en bronnen: Rust © Rust Foundation (CC BY 4.0, vorm en kleuren ongewijzigd); Zig © Zig project (CC BY-SA 4.0, vorm en kleuren ongewijzigd).
- Overige logo’s: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard